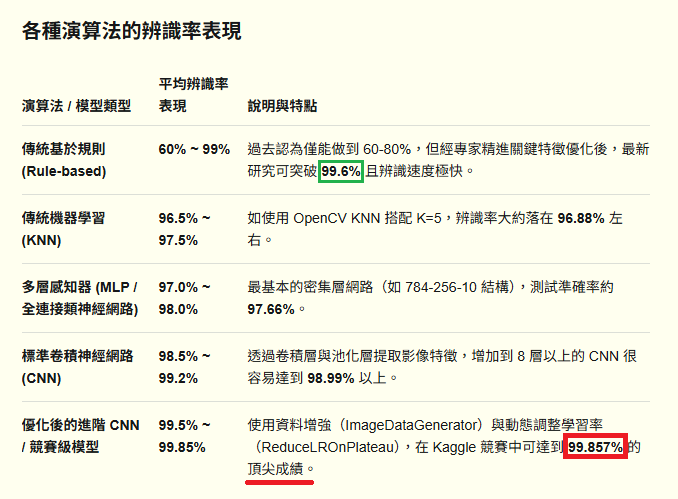
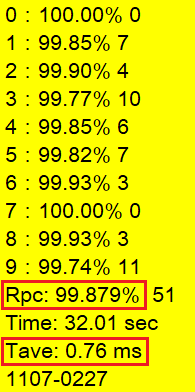
上面是Google AI的最新手寫數字辨識率報告!終於跑出了一個具體的冠軍辨識率99.857%!這馬上就激起了我的鬥志!我昨天的辨識率是99.852%,距離只有一步之遙,哪能不更進一步積極奪冠?於是再打開程式強攻剩餘的數十個昨天尚無法辨識的案例,也立即多破解了11個案例!辨識率達到如上所示的99.879%!立即搶下世界冠軍的寶座!
覺得我太浮誇嗎?那就下載我的展示軟體自己測試吧!它可以一一匯入MNIST(規格)的灰階圖案例做辨識的!我不會作假,也不屑於作假的!
http://www.ezonesoft.com.tw/EzoneSoft_HWdemo.rar
其實因為我是使用明確的規則(Rules)作辨識的!所以對於極端特殊的案例只要努力思考出夠多的細節資訊加以限制,就可以針對性地將困難案例精準掌握辨識成功!相對的DL與CNN的方法都是隔靴搔癢,要透過非常龐大複雜難以掌握的間接統計方式才能提高辨識率。所以只要我的基礎建設做得夠好了,要在這個牛角尖裡面比拚極端的辨識率,我是更具優勢的!
當然說實話,這種微小也極端的辨識率差異,對於日後實質應用時的辨識能力差異是微不足道的!只表示我們的程式可以辨識出MNIST字集裡面非常詭異不合理的極端案例,但那些都算是隨機誤差了!真實世界剛好會出現那種怪例的機會微乎其微!所以認真比拚這種極高辨識率,真的就是在鑽牛角尖了!
我這麼執著爭取世界冠軍的意義,首先就是要破解Rule based方法無法達到高辨識率的錯誤觀念!證明設計良好的Rule based方法,在有特定範圍的影像辨識議題上,絕對可以挑戰甚至超越深度學習的表現!一旦做到了,就表示我們可以同時享受到高辨識率與高效率,製作出低成本的AI辨識軟體!
事實上,如我之前一再強調的,在此手寫數字的辨識議題上,98%以上的辨識率其實就算是Overfitting了!根本沒有必要繼續追高!以深度學習的理論上來說,只要使用更多細節特徵(與組合),讓模型複雜度無限擴大,在有標準答案的集合裡,辨識率當然可以繼續挑戰極限!但是使用極高成本,追求極微小的效能有必要嗎?還是他們也沒正經事好做了?就繼續誤導麻醉AI迷吧?
我刻意搶奪這個議題的世界冠軍,只是希望以為DL與CNN就是影像辨識唯一主流的AI迷們可以醒醒了!那絕對是一個錯誤的迷思!Rule based之前表現不夠好,不是這個概念方法本身有問題,只是大家還不夠努力而已!尤其是機器學習盛行之後,幾乎所有人都放棄努力了?不再繼續研究的技術怎麼會進步?現在Rule based方法真的成了辨識率冠軍,你該怎麼說?又該怎麼想?還要繼續說DL與CNN最棒嗎?

限會員,要發表迴響,請先登入


