有關MNIST手寫數字辨識資料集的使用,我一再強調我不會追求極端的高辨識率!但我的實際作為似乎又有點自相矛盾?表面上我每天的努力目標還是在追高以該字集的標準答案為依據的辨識率?昨天就剛剛突破96%了,還想繼續追高到97%或98%?要繼續調整,或稱「訓練」到多高才是我認為的合理終點呢?
我也不確定的!我必須走到那個所有我建立的邏輯都開始兩難,已經無法將辨識邏輯調整到更合乎一般人的認知時,我才會罷手!那不是一個可以明確定義的標準。因為研究過程中我也必須依賴一個有參考價值的統計值做為自我評量的標準,雖然MNIST字集的答案不是很完美,但是我自己將42000的影像一一重做標記,也不會更有公信力!
可以確定的是:如果你不問是非,只讓電腦自我學習到辨識率百分百,那一定會Overfitting(過度擬合)出一個不合理的模型!機器學習的過程是沒有理性分析的!不會分析字集中自相矛盾的答案之間的合理性,好像極權制度下的人民,不敢談理性科學事實,只能將獨裁者的不合理命令都盡量合理化歌功頌德!他們說主觀標記的答案就是Groud Truth嘛!意思就是所有使用者都不能質疑挑戰這部份的!
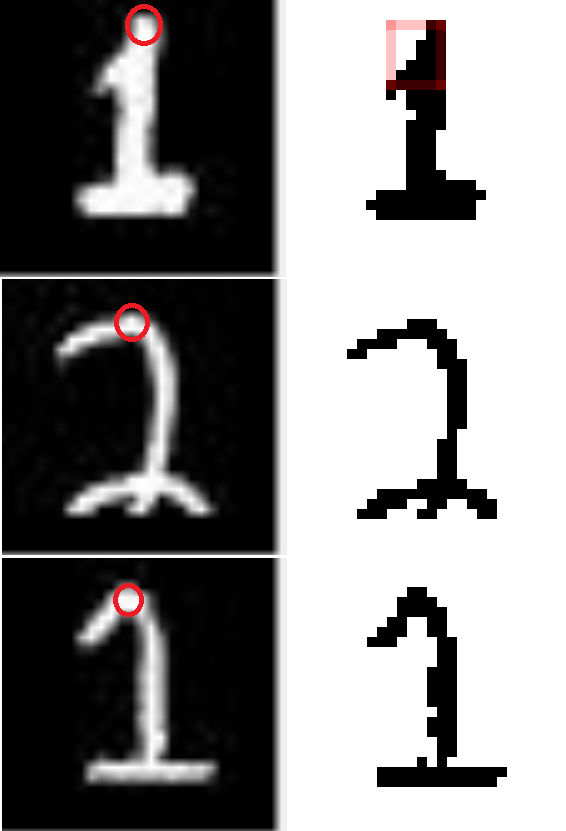
如上的三個案例分別是121,很多人確實會將數字1寫成有頭有尾,如常見的印刷體一樣!但是寫得太瘦長的2就會很像這種1字!我目前的辨識核心也無法做出跟字集答案完全一樣的結果!但我會嘗試建立一些細微特徵去趨近一般人的認知!譬如:
1字尖頂的水平位置應該與中軸位置一樣,如果偏左就是頂部圓滑的2!
但是上圖下方的1字案例就馬上給我打臉!MNIST說這個1字的頂部就符合上面我建立的2字辨識標準!所以使用我的這個辨識標準後,未必可以讓整體辨識率更高!因為雖然某些近似1的2案例是被救活了!但是某些略為圓頭的1字又會被誤認為2了!就是所謂的順了姑情失嫂意,進入兩難的狀況了!
我現在努力的就是還是繼續大量建立這種我知道不是單一特徵就能下定論的邏輯,也建立讓它們可以量化的參數,再調整使用這些特徵條件的優先次序與量化門檻,甚至淘汰掉那些怎麼使用都無法讓整體辨識率變高的無效條件!這個過程其實就是機器學習或深度學習希望電腦自行調整出完美模型的過程!加入某條件後辨識率變低,就是所謂的Lost Function值太大,必須調整模型參數的意思!只是我是以以科學家的理性去主導建立我的Rule based模型!
我想讓大家理解相信的影像辨識理念是:即使是這種模糊複雜程度的辨識,如果你堅持讓專家的人腦主導這個「訓練」過程,最終一定還是會比胡亂抓瞎嘗試錯誤打誤撞的ML或DL結果更準確的!不然他們還需要甚麼「監督式學習」?就是因為純機器學習太笨,需要更多專家的知識與理性介入才能趨近合理的結果!
所以千萬不要被AI廣告洗腦了!誤以為我的這條不用機器學習作影像辨識之路是效果「不好」的過時方法技術!事實是這種純專家知識主導的「訓練」方式的結果一定是比較好的!因為過程精確所以這種「模型」的計算量一定少很多!不僅效率高還會更準確!
這個事實其實AI專家們都知道!也絕對不敢否認的!他們會傾向採用機器學習只是覺得完全用專家知識主導的研發方式太辛苦也太困難了!但是機器學習可以讓這些「AI專家」直接變成旁觀者!拿張板凳坐著看電腦演戲就能領薪水了!甚至不需要影像辨識的專業知識也能入手做到八成像樣!何樂不為呢?
我不會否定ML等所謂AI技術的存在價值,但是以商業化影像辨識產品而言,我的方式絕對不是比較不好或已經過時?反而是CNN、DL與ML等技術,在此議題下是高成本低效率的較差選擇!很多廠商應該都已經以身試法失敗過了!只是沒有人敢像我這樣直言不諱而已!

限會員,要發表迴響,請先登入


