他們說在我之前的Rule-based方法做的辨識率都不高,大約都在60-80%而已,但我的版本卻能挑戰最尖端的DL與CNN的極高辨識率?最後收在99.7%!這中間有何差異?讓我很想研究看看,如上Google報告描述的幾何特徵其實跟我使用的也相差無幾,比較不同的是我很注意「凸出點」,但完全無視「交叉點」!
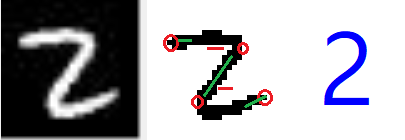
如上的2就是左右各有兩個凸出點,我會在這些凸出點之間找出相對的「凹陷點」,這就是我使用的最基本初級特徵!這些點的上下左右相對位置就已經能作極佳的辨識指標了!接下來是可以獨立辨識出的線段,包括上面2的中間線段,與左右凸出主體範圍的線段,它們的位置與長短也是我使用的重要指標!太糾結於影像中心的鬧區特徵其實效益不大!這是我的經驗。
我想我主要與傳統Rule based方法的最大差異是:我並不是用特徵條件來判斷影像「像」甚麼數字?而是先假設案例可能是0-9的任何一字!然後利用這些特徵找出它「不像」某個數字的理由,反向逐一淘汰可能的答案!譬如2與5的左右凸出與凹陷點數都一樣,但是凹陷點的上下位置不同,一看就知道像誰或不是誰了!淘汰到最後一個可能性時就是我的答案了!所以我稱之為「福爾摩斯定律」!
也就是說很多你從正面解讀某影像的特徵時,並不太符合2字特徵的影像,但是它更明顯的「不符合」所有其他字的關鍵特徵,這個字就會被定案為2了!所以我的辨識流程是個以定性為主體的淘汰賽!而不是累積總積分比高下的十項全能比賽!遇到字體好辨識時,積分與淘汰策略表現都會很好,但是碰到難辨識特徵較不明確時,淘汰賽會更有效率也更能準確「猜」到難辨的字!
上述的福爾摩斯策略讓我的辨識率大幅超車贏過了之前數十年所有的Rule based前輩,達到跟DL與CNN可以並駕齊驅的高辨識率!其實辨識速度方面應該也是比其他Rule based方法快的!但DL與CNN的辨識率是怎麼贏過我的這些前輩的呢?答案就是上面這段敘述了!其實就是使用了比傳統Rule based更低階破碎的特徵,以及各種特徵組合的比例權重的資訊!
但這兩個優勢都必須奠基於更大量的計算!特徵數變多,特徵組合可能性更多,評估低階特徵與特徵組合權重的計算量更是大如天文數字!所以他們的辨識速度才會變得那麼慢!辨識模型體積更是暴長成如酷斯拉般的超大怪獸!辨識率確實是高了,但是代價實在太大了!所以才會失去實用性,只能等待輝達等硬體廠商做出可以應付更大運算量的硬體來救援!沒有GPU就不能活了!
其實我也如DL與CNN一樣,有適時使用更低階特徵與各種特徵組合的資訊!但是我採用了比較偏向「定性」而非「定量」的策略,譬如某種特徵組合出現時就直接據此判斷目標案例比較像某字,而不像另一個字!據此淘汰某個可能的答案,而不是費事去計算這些特徵組合對應於某個字的權重!
就像要找出兩個人誰比較健康強壯時,替兩個人做健康檢查,詳細評估所有醫檢數據挺費事的!但直接讓他們坐下來比腕力就很簡單快速了!我的辨識軟體就是按照這種策略運作的!沒做之前我也不知道行不行?但我知道一定不能仿效DL與CNN的做法!那樣做就會跟他們一樣慢了!事實證明我的策略是成功的!
所以我不打算搞神秘!中研院或任何公司或學術單位,如果有興趣邀我去交流演講我都會欣然接受,坦白說明所有技術關鍵的!程式碼細節當然還是會保留讓我能做點生意賺點生活費的!也希望其他後進可以參考我的成功案例,不要只是一頭鑽進ML、DL與CNN等狹義的AI技術就完全不看其他可能性了!對影像辨識來說,DL根本不是最佳方案!Rule based才是康莊大道!


限會員,要發表迴響,請先登入


