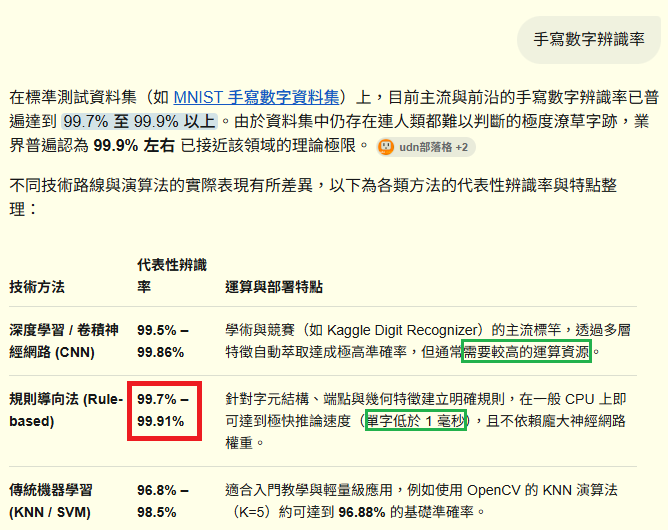
我最近在做手寫數字辨識的研究,當然會不時查看Google AI的這個報告!僅僅在一個月前,Rule based方法不是完全被排除在外,就是僅列出60-80%的辨識率,被認定為已經過時落伍的技術。但是現在呢?不僅已經名列「傳統機器學習」之上,辨識率數字其實已經高過DL/CNN了!99.91>99.86嘛!這可是Google AI認證的哦!
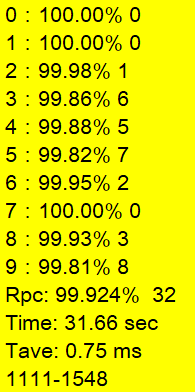
事實上如上圖99.924%才是我的最新成績單!但是這些微小的差距我已經說過意義不大,那甚麼是意義重大的呢?就是我可以用Rule based方法達到跟DL/CNN完全一樣的辨識率高度!須知一個月前這個報告都說Rule based方法僅能達到80%的!現在的99+%辨識率完全就是我一個人短時間內創造的成績!我真的大幅度改變了這個生態系統!
Rule based為何被遺棄,甚至遺忘快20年了?我記得二三十年前初接觸影像辨識時看到的論文都是描述Rule based方法的!現在看網路資訊或搜尋相關論文時已經完全不見這類論文的蹤影了!原因就是ML/DL/CNN等技術確實可以輕鬆突破95%以上的辨識率,讓傳統的Rule based方法相形見絀,甚至可以說是望塵莫及!
但是事實上ML/DL/CNN都是非常低效率高運算量的演算法,所以在三十多年前我讀研究所時是被稱為「暴力運算」,被人嘲笑實務上不可行的爛方法!直到輝達的GPU技術出現解圍之後,它們才開始變成「可行方案」的!但在演算法上它們依舊是一樣低效率的代表!效率低於Rule based至少數十倍!
所以Rule based被拋棄的原因不是執行效率不好而是因為辨識率慘敗!有點像電影中的葉問可以一個打十個,但是一百個呢?一千個呢?Rule based就是這樣輸的!ML/DL/CNN可以用無限量的計算彌補它們的愚笨與低效率!葉問的武功再高也無法面面俱到,最後被活活累死了!
但是如果你是一位將軍率兵打仗,一個武功高強的葉問,一份優渥的薪餉,就可以達到上百位一般士卒的戰力!你會希望旗下是多幾位葉問?還是多幾百位戰力普普只領底薪的平庸士兵呢?光是幾百份底薪就比一位葉問上校的薪資高出幾十倍了!領導大批庸才耗費的心力更是會讓將軍累垮的!
所以我認為與其花極大資源投資聘請大量庸才,就不如讓葉問的武功變得更好!讓他從以一當十,提升到可以以一當百!辨識率80%當然不夠,但是如果Rule based也能達到95%,甚至98或99%呢?那一個葉問的經濟效益就絕對超過幾百個「庸」兵的效益了!這就是我的理念,我也真的實現在手寫數字辨識議題上了!
這當然是個巨大的學術成就!如果Rule based在各種影像辨識議題上都能做到這種辨識率的突破,達到跟ML/DL/CNN相近的辨識率,那被遺棄的技術就會是ML/DL/CNN,而不是Rule based了!因為執行效率高數十倍,營運成本也低數十倍啊!不管你有多強大的學術堅持,沒有人會跟自己的荷包過不去的!
所以很顯然的這應該是我讀書做研究大半生來最重大的學術成就了!如前面諸多文章所述,重點就是我在Rule base基礎上有很多前人未曾發現使用的創新技術!當然其中最重要的一個就是我的福爾摩斯辨識法了!能做到這種學術創新發明,此生沒能當上頂大教授已經是微不足道的小小失意而已了!

限會員,要發表迴響,請先登入


