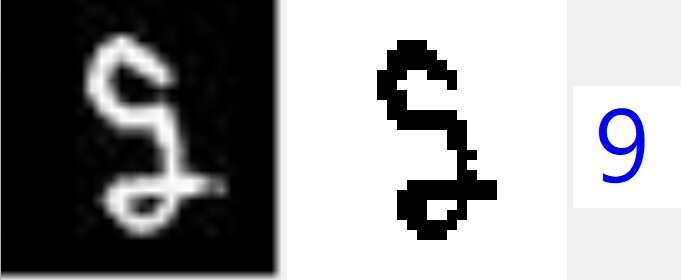
目前最新的MNIST手寫數字辨識率是98.888%!好多個8表示一路發,應該是個好兆頭吧?之前我第一個擔憂的是辨識率如果達不到98%這個一般商業化影像辨識常用的標準,以後推銷產品時會有壓力!我上次洽談手寫數字辨識的案子失敗就是我當時只敢承諾95%,但是客戶希望至少是98%!
現在我已經突破98%逼近99%了,這個低標的壓力解除了,我第二個擔心的事情是:我知道以MNIST部份太異常的案例,且不太精確的標記答案為基準,會造成Overfitting的現象!這些為特殊異常案例量身定做的不正常辨識原則有可能讓我日後產品的辨識埋下地雷,出現異常的辨識結果?
但是這幾天做了不少類似上例的Overfitting辨識,它應該是個9,但是因為筆劃誇張變成比較像8或5的特徵!但是分析一些次級特徵譬如中間靠右的短線,搭配下方「左邊」的一個封閉區間,如果圈圈靠右當然就像是6了!但它都不對勁嘛!就把它當作例外處理,真的不符合已建立的所有原則時,就根據MNIST的答案回應就好了!這就是符合MNIST標準的「正確」辨識了!
我也開始想到要符合這麼奇怪的特徵組合也非常罕見!一般正常案例根本不會走到這個辨識流程中的岔路死角!所以我即使為了求更高的MNIST辨識率分數,替這些不可能在真實世界出現的極端案例設計特殊的辨識原則,也不會影響未來的真實辨識率的!所以就更大膽的天馬行空放手做Overfitting了!所以辨識率繼續提升之中!
當然以上想法是我用Rule based方法實作的狀況,也可以說因為我是精準且精密的儀器,每一個辨識流程都是獨立進行合理且有序的!所以即使有很多只適合用於詭異案例的辨識原則,因為條件限制充分,正常案例根本不會觸及它們!有點像某種罕病病患可能必須吃砒霜才能治得好,但是一般病患不可能被診斷成那種罕病,也就不可能誤吃砒霜致命了!
如果是深度學習做同樣的事情呢?他們的每一個Lost function的評估都不是像我做的那麼精確的!都是以機率評估猜測的!所以任何Overfitting必然會影響到全局的!要避免辨識最終的錯誤怎麼辦?就必須建立更多的評估方式與公式,希望「集思廣益」嘛!也就是模型必須做得更大!計算量越來越多,執行效率當然就越來越低了!
很可能用他們的AI方法,在98%與99%之間,每增加一趴的辨識率辨識速度就會慢一倍,甚至好幾倍!也逼得他們只能放在雲端的超級電腦上跑了,值得嗎?相對的,我的Rule based方法呢?從剛開始的一千多行程式,辨識率90%,到現在的一萬三千多行程式辨識率98.888%,辨識單字的時間都是一樣,約0.8毫秒,不超過一毫秒的!
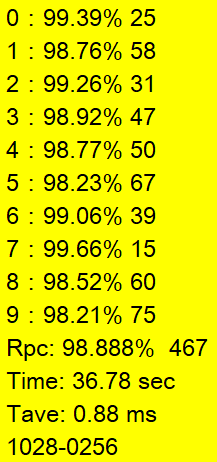
這就是CNN與DL等所謂AI方法的罩門!他們必須做很多Overfitting才可能達到更高辨識率!但是Ovefitting會影響到已能正常辨識的狀況就必須建立更多函數評估方式來修正,疊床架屋之下就變成一個超級大的怪獸了!相對的,Rule based方法就完全沒有這種問題!所以才能在架構越建越大時依舊保持高效率!我也是做到最近的這個巔峰境界時才體會到的!
其實回到二三十年前,當時的AI主流就是Rule based方法而已!所以不要再被誤導只有ML、DL與CNN才是AI了!以影像辨識的議題來說,Rule based不但不應該被低估淘汰,反而是應該積極發展救治ML、DL與CNN弊病的救命良方!重點是Rule based方法本身根本還沒被積極開發成熟!我只是先驅而已!

限會員,要發表迴響,請先登入


