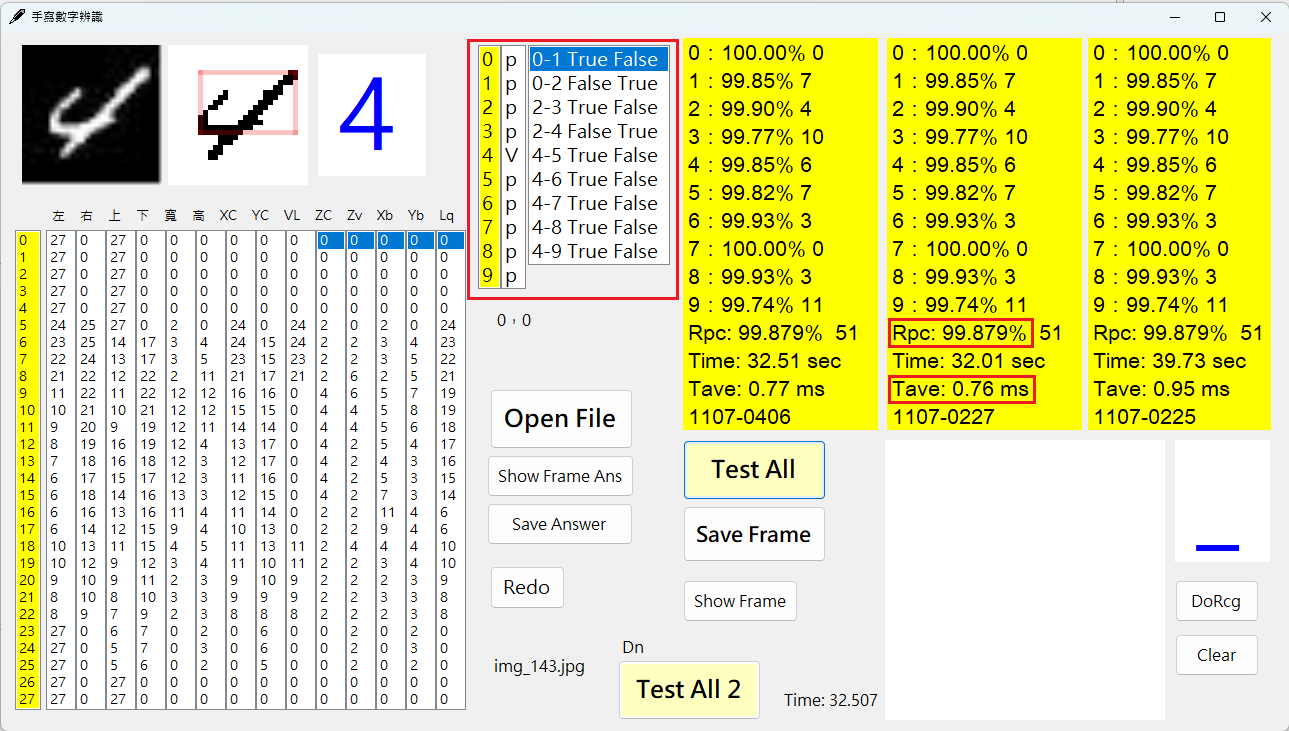
這就是陪著我奮戰了三個多月的實驗程式介面!也幫我一舉拿下手寫數字辨識率的世界冠軍!這是Rule based方法翻轉世人印象的逆轉勝與大反撲!當它在前面二十年都快被世人遺棄時,我硬是做了一次文藝復興大革命,證明傳統的非機器學習方法仍然可以在複雜變化大的議題上與新興的AI科技一較高下!
我的成功當然是有很多創新的概念包含其中!如果總是蕭規曹隨陷入前人研究的窠臼,即使有進展也是非常微小的!所以我這次使用的Rule based方法其實跟前人,甚至我自己前面十幾年使用的Rule based都有很大的不同!其中最關鍵重大的革新就是來自這句福爾摩斯的名言:
當你排除了所有的不可能,無論剩下什麼,就算多麼難以置信,也必定是真相。
When you have eliminated the impossible, whatever remains, however improbable, must be the truth.
我確實就是依據這個理念設計出我的程式架構主體的!因為我一開始就知道手寫字沒有標準字模,所以無法穩定的依據與字模的相似度做出量化指標,任何嘗試給目標案例「打分數」選出正確答案的方法都會滯礙難行!我也意識到這就是前面幾十年Rule based無法突破進步的關鍵魔咒!大家都想替案例打分數,但分數永遠不穩定不可靠,我絕對不能重蹈覆轍!
所以我的辨識流程可以說是逆向思考的大革命!從擇優錄取變成淘汰賽制!一開始就假設目標案例可能是0-9之中的任何一個字!然後依據各種原則(Rules)找理由一一淘汰可能的答案,如福爾摩斯所言,當只剩下最後一個可能的答案時,即使它看起來非常不像那個數字正常的樣貌,它還是最佳的答案!
因為從來沒聽說過有人這麼做影像辨識,連我自己也是第一次嘗試,所以一開始真的不知道行不行得通?在上面的程式介面中我最頻繁關注的就是中央紅框所標示的淘汰賽戰績表了!每個案例從評估比較像是0或1開始,誰贏了就與更大的數字繼續捉對廝殺!最後沒被淘汰勝出的就是答案了!這次是4獲勝!
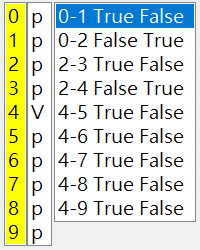
如果我的答案與標準答案不同呢?就是從這個表追蹤是哪一場淘汰賽出了問題?做出了不合理的判斷。那就要進入這個比賽的Function之中調整比賽規則(Rules)了!這是一個連鎖反應,只要某個場次錯了,錯過對的答案,結果當然就一定錯了!我的工作就是依此架構讓我的每個淘汰賽制都盡量公平合理!
就是這樣!我建立的規則越來越多越繁複,但是過程謹然有序!最後達到近兩萬行程式碼的規模!但整體架構還是謹謹有條,絲毫不亂!每次做了任何Rule的修改就立即按下Test All按鍵做全面42000張MNIST案例的測試!時間大約就只是三四十秒,很快就知道我單一的修改動作對於整體辨識效果的影響!辨識率下降時當然就要檢討這個Rule是否洽當了!
說實話,我短時間之內做出這樣的成績,易地而處人家說這種故事給我聽我也會不相信!但這個故事絕對是真的!所以我盡可能讓讀者多看到一些具體內容,這樣要造假當然是不可能的!因為這個成功的大膽創新福爾摩斯居功甚偉,所以我想命名它為「福爾摩斯辨識法」!Holmes Method!

限會員,要發表迴響,請先登入


