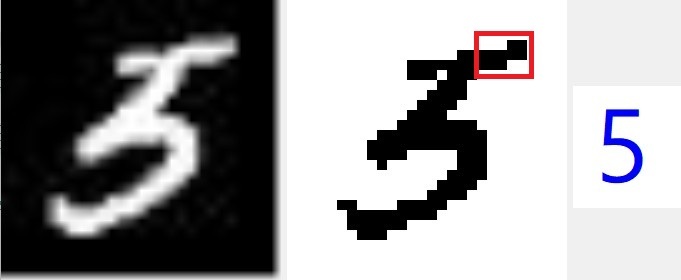
我的手寫數字辨識率已經推進到以MNIST字集為標準的97.3%以上了!每0.1%的推進都是好幾天的努力成果!但是我到底在忙些甚麼東西呢?大概就是研究如何判斷像上面這種模擬兩可的案例了!按照我建立的一些辨識的「通則」,也就是俗話說的大原則,這個字會被辨識成3,它也確實很像3!
但MNIST是把它標記為5的!有道理嗎?當初可能只是參與該計畫實驗的學生被要求寫一個5,不管寫成甚麼樣子,都算是5了!最多就是計畫主持人用他們自己的理解能力與常識排除依些太離譜的案例而已!簡單說就是沒有明確標準的!只是計畫中人的主觀判斷而已!不是甚麼不可挑戰的神諭!但他們給了這些答案一個神聖的稱謂,叫做Ground Truth!字面上的意義就是不可挑戰的事實!一切辨識率高低都是以此為基礎的!
我是想以Rule based製作這種辨識系統的!我不必尊重這種Groud Truth,但是我很尊重他們的直覺與常識中隱含的辨識邏輯!因為我的直覺也同意它應該是5,所以我就要找出我自己認為它是5的原因!我的答案就是上圖中紅色框框標示的特徵了!正常手寫3的筆劃順序是不可能寫出那個突出線段的!它太細了,必然是一個刻意的筆劃而不只是一個轉折!所以它一定是5!我的程式工作就是建立一個凌駕通則之上的特例處理機制,讓它被辨識為5!
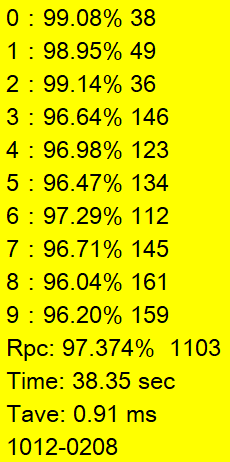
以MNIST字集的42000個案例來說,我的「通則」建立完畢時辨識率就大概有95%了!之後每處理好一個「特例」,辨識率就可以提升1/42000,每提升0.1%就需要合理的處理好42個這種案例!就像在垃圾回收場努力找到遺珠一樣的意思!正常來說每天可以處理好十個這種案例就很辛苦了!這就是我正在忙的事情了!就是讓辨識結果「更合理」!如下是我最新的成績單,42000個案例中還有1103個案例答案與MNIST的標準答案不同!我希望從中再撈出約三百個特例就是98%辨識率了!
如果我是用CNN與DL等技術做這件事呢?那當然就是完全不同的景觀與故事了!我的工作只是整天都在調整連我自己都不知道有何實質意義的參數!譬如多增加深度學習訓練模型的隱藏層數目,或是使用甚麼XNN第幾版等等!他們只能這樣很間接地抓瞎嘗試錯誤,然後看看辨識率成績有沒有進步?即使辨識率高了,他們也完全不知道電腦模型是如何辨識的具體過程內容!
這樣做影像辨識的人能算是「影像辨識」的專家嗎?嚴格說他們對影像辨識的實質內涵理解程度與一般人無異!就是所謂不知而行的典範了!當然以結果論,如果就是可以得到高辨識率也算是一種成就了!那我為何不喜歡跟著大家一起這樣玩呢?原因實在太多了!
首先是大家一起抓瞎淘金會把這個遊戲變成碰運氣的比賽,即使有優勢的人也只是資料取得較容易或是統計學技術較好,不是影像辨識知識較多!我在這些方面當然毫無優勢競爭力,必敗無疑的,還玩甚麼?其次這種方式產生的模型執行效率絕對遠遠不如Rule based架構的模型,即使做得出來也是笨重低效率的系統,很難商業化變成廉價普及產品的!我是商人,投資做這種不實用的東西沒意義!
也因為我是商人,做出產品能賣只是一個起點,售後服務優化升級除錯都是必須要持續做的事情!當客戶質問我某些案例為何辨識錯誤時,我必須像個「專家」一樣很具體踏實地跟客戶解釋原因,還必須精準的修改軟體因應這些例外!這些都是使用CNN與DL根本無法做到的事情!
也因為我是商人,會考慮到產品價格與運轉成本的問題!我知道不知而行硬是用巨量資料與超級算力訓練出來的龐大模型就是一個計算量極高的吃電怪獸!沒有昂貴的硬體與高額電費支援根本跑不動!東西貴了就沒人買得起了!所以我必須繼續往Rul based的方向努力!即使是千山我獨行,也不必相送了!


限會員,要發表迴響,請先登入


