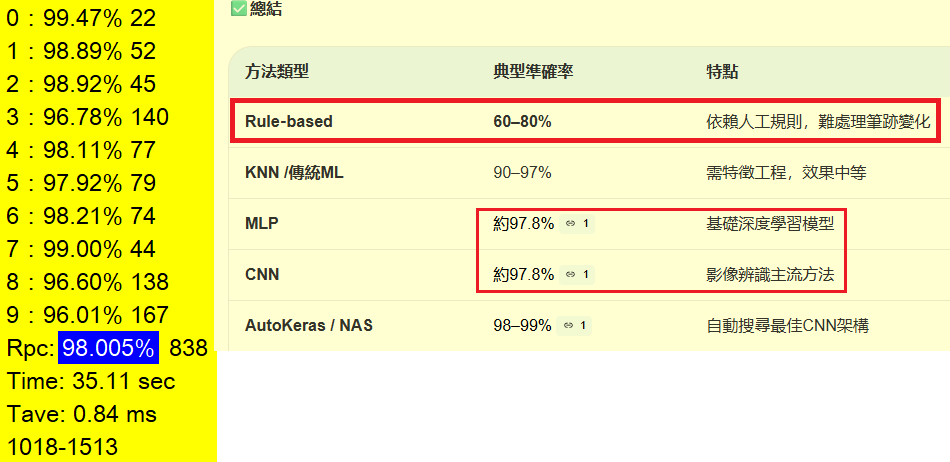
太不可思議了!只用了約80天,我真的用Rule-based方法將MNIST手寫數字的辨識率做到了98%!而且還有繼續提升的空間!如上圖根據Bing AI的報告說:不用DL與CNN的傳統方法應該只有60-80%的程度?可見我真的完成了不可能的任務!應該會讓這些AI統計報告亂一陣子!
這些年來因為很多主觀與客觀的因素,我的影像辨識技術發展方向好像一直與主流派的ML、DL與CNN等他們自稱的AI技術背道而馳?我也很誠懇踏實的每天用我自行研發的實際案例經驗分享,想讓讀者們看到我看到的事實!跟其他網路資訊看到的大不相同,但我真的就是這麼想,也一直是這麼作的!
重點是我的觀點對了嗎?真的可以不必用ML、DL與CNN做好影像辨識嗎?到底是我「離經叛道」的特異觀點有道理?還是如上AI統計資料所說,影像辨識的Rule-based方法技術已死!早該變成歷史的灰燼了?是Rule-based方法毫無前途?還是只是前人對於這種研究方式還不夠深入努力?
其實我只是發明了一套很有創意也很有效的Rules來辨識手寫數字而已!當然基礎是我十多年來使用Rule-based方法研究各式影像辨識議題累積出的豐富經驗!一般初學者應該辦不到!但已經能證明並不是Rule-based的概念行不通,只是研發者還沒找到夠聰明有用的Rules而已!
重點是ML、DL與CNN並不是AI宣傳說得那麼完美!重大缺點包括他們的極高成本與超低效率,辨識率越高需要的模型就越大,訓練成本就越高!執行模型應用時需要的計算量與耗電量也會呈幾何級數增加!所以才會那麼多人都可以自己訓練模型,市面上堪用的辨識軟體卻非常罕見!
辨識率低模型小的產品使用者無法接受,辨識率高模型大的就跑太慢或建置成本太昂貴了!所以我才會有強烈動機這麼努力研究這種手寫數字的辨識!如上我的成績單所示!目前的辨識核心跑完42000張MNIST案例的時間是35.11秒,平均辨識一個字的時間只需0.84毫秒!而且就是在我使用的一般規格電腦上只用單一執行緒作的!完全沒用到平行運算、GPU或任何額外硬體!
看到這種驚人的高效率了嗎?如果辨識率的落差根本沒有上面的AI報告說得那麼大,把我的新研究資料加入這個列表,那應該被嫌棄的就不是Rule-based方法,而是DL與CNN了!我很高興我用實際的行動證明了我十多年來堅持的理念!即使是像手寫數字那麼複雜混亂的辨識議題,還是可以使用傳統的Rule-based方法將辨識率做得跟DL與CNN一樣好的!


限會員,要發表迴響,請先登入


