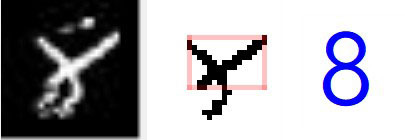
如上面一篇文章說的,影像的二值化也是辨識流程的一部份!事實上MNIST的原始影像就是像上面這樣的灰階影像,也會有一些非常模糊破碎的案例,讓二值化很難做到完美!我們就只能辨識「剩下來」還算清晰的「部分」影像了!這種問題我在前面十多年研究車牌辨識時就很熟悉了!所以這也是我目前做這個研究的優勢之一!
所以在此Rule based中的Rules的使用就很微妙了!你如果假設每個字都是大致完整的,整體辨識率就很難突破95%了!你必須有面對破碎字元時的「猜題」能力!就像賭神電影中的情節,如果只看到紙牌數字的一部份時,你還是必須判斷最可能是甚麼字?
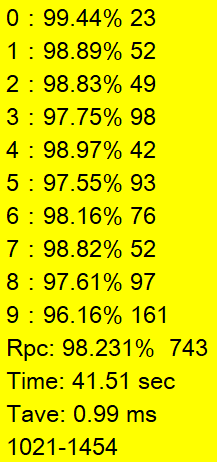
我目前已經做到MNIST辨識率的98.383%了!也就是剩下還無法辨識正確的案例幾乎都是這樣模糊破碎或筆畫超級異常的狀況,也就是想整體評估所有特徵來做判斷幾乎是不可能的!簡單說就是必須有「捕風捉影」根據不完整的片段線索來做評估猜測了!
機器學習要辨識這種案例就是依據「經驗」!如果有夠多奇怪的案例加上標準答案為指引,讓電腦自己建立更多細微特徵差異就可以辨識更多異常案例!這當然是很沒效率的暴力運算!所以當他們想要追求這種極端高處的辨識率時,模型就會大幅的複雜化!計算量就暴增了!
相對的,我的Rule based方法就沒有這種問題!我的解題方式是用人腦智慧精確解答的!所以就像醫生治病,並不是難治的病就一定要吃更多的藥或做更多的療程!重點是對症下藥!吃對了就治好了!所以效率很高!如上所示:即使辨識率這麼高了,辨識時間還是一樣快!0.84毫秒一個案例!
所以我的辨識核心才是商業化推廣的優勢產品!那是任何DL與CNN的高辨識率模型都完全望塵莫及的!這才是我做此研究最重大的意義!還在努力提升辨識率只是我想徹底封住所謂主流派AI的嘴!毫無懸念!我的辨識率一定可以完全追上最頂級的DL與CNN模型的!


限會員,要發表迴響,請先登入


