現在做影像辨識的領域,大家都預設是使用機器(深度)學習與類神經網路了!所以我這個不使用機器學習的研發者不時會碰到尷尬的情況,譬如專案的評審委員會問我是如何「訓練」我的模型的?如果我直言我根本不用機器學習,常常會讓對於AI技術已有定見的委員不高興,直接認定我的技術已經落伍了?這當然對我很不利,要完全解釋清楚也很難!
但是久而久之我也發展出一些應對的策略,我可以毫不心虛地說我用的方式是高度控制的監督式學習!這不算說謊!機器學習基本上是放任機器自主學習,也就是自我調適找到最佳參數組合!我的辨識邏輯則是自主設計,機器學習失控時他們也會人為介入,強加一些有利於正確辨識的條件,就稱之為監督式學習了!我只是監督介入的程度更高而已!
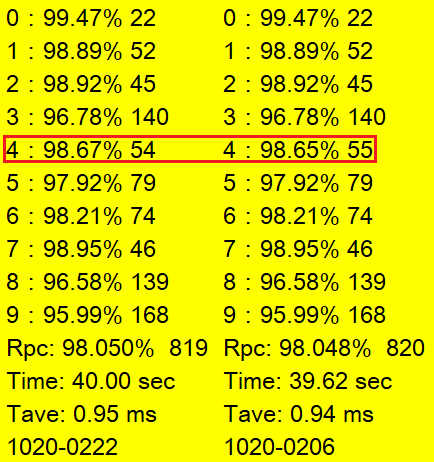
如上圖,是我微調辨識條件之後做的兩次MNIST42000張影像的全程實驗報告,這次調整讓我只多辨識成功一個案例!但沒有辨識失敗的損失,這就是一次成功的訓練了!這種過程稱之為「訓練」不算謊話,因為機器學習的訓練過程也是一樣的!調整參數看看整體效果後決定下一步調整的方向!經過無數次的訓練模型的辨識率就越來越高了!我也是在做一樣的過程,只是我介入控制的程度更高而已!
這很像那些千萬超跑的製程!汽車需要的製程都是一樣的!大部分廠商為了降低成本是自動化讓機器生產的,千萬超跑則是每一個製程都由資深工程師手工製作的!我的作法當然比較燒腦,但是不會讓成果變成失去監督控制的黑盒子!機器學習可以說是一大堆臭皮匠濫用資源強制拼湊出辨識率很高的龐大模型!我則是以更準確有效的邏輯設計與調整(訓練)我的「模型」!
所以很多研發過程我與機器學習也很像!他們需要不斷重複實驗檢視Lost Function決定下一步!我也一樣的!每一個辨識邏輯我雖然能掌握它本身的意義,但是我無法直接預判到這個細微的改變對所有資料的整體損益!所以也必須作全部資料的實驗評估!差別只是我可以更精準地控制計算量,實驗成本會比機器學習低很多倍!意思是用人腦的時間較長,但用電腦的時間則精簡很多!
我希望大家更理解也相信我的作法是可行的!而且是優於DL與CNN的!所以我不搞神秘!不想用AI虛名唬弄讀者客戶!我會盡力讓每一個人都知道我的具體作法!


限會員,要發表迴響,請先登入


