手寫數字的連體嬰也可以處理了!
2026/11/17 14:13
瀏覽14
迴響0
推薦0
引用0
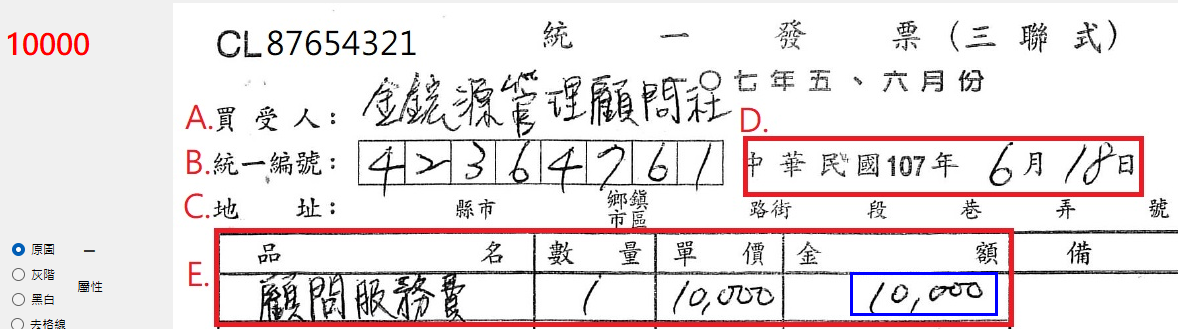
前兩天提到這種手寫數字常見的連體嬰,也是基礎OCR方法的一個罩門!因為上面10,000中的後面三個0是相連的,無法直接被視為三個數字0,加上還有一個分段落用的一撇容易被誤認為1,所以前幾天還無法正確辨識。今天趁空就實作了合理的解法。
關鍵就是發現寬高比異常的目標時,必須加以正確合理的切割後再辨識,加上如果在目標區發現太矮小且位置偏下方的1字目標時要加以忽略!當然我的處理程序是建立了,但是手邊類似案例還太少,碰到更多類似狀況時的彈性處理能力還未受到考驗,必須有真的案子開工時,客戶提供更多資料後再調整了!
這個例子應該可以讓各位讀者體會到,真實世界的影像辨識並不是把MNIST的幾萬個影像研究透徹,辨識率達到99%就可以做好的!如果每個案例都是標準規格的28X28畫素影像,你真的可以完全不懂影像辨識的原理技術,只要會套公式操作ML/DL/CNN的訓練方法就可以作出高辨識率模型的!
但是從一張真實的文件影像,到切割出可以被饋入你的模型或辨識核心的單字影像,這是一段既複雜又漫長的路!如果沒有豐富熟練的OCR技術是根本摸不著邊的!所以幾乎任何機器學習的初學者都可以很快開始加入MNIST的競賽遊戲,甚至獲得高分!
但是要真的能從真實文件影像中辨識手寫字呢?至少必須再練功三年!而且那些功夫是完全與ML/DL/CNN無關的!即使是所謂影像辨識函式庫OpenCV中應該也不會有這種進階處理函數的!即使有都需要很多的參數調整,沒學問的人是一定搞不定的!誰說只要會ML/DL/CNN你就可以很AI了?

你可能會有興趣的文章:
限會員,要發表迴響,請先登入


