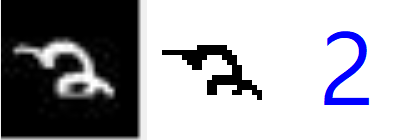
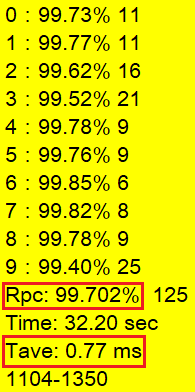
如上所示,我的MNIST手寫數字辨識目前已突破99.7%了!但是這幾天研究的都已經是非常妖魔鬼怪的異常案例,繼續為了這些隨機的雜訊建立太多特殊的規則,只是證明我可以用Rule based方法做到這些事情而已,對於日後軟體面對真實世界的影像辨識能力已經幫助不大了!所以決定適可而止暫時收工了!如我之前說過的,太極端的辨識率追求只是Overfitting而已!我原本只想止步於98%,如今都到99.7%了?真的夠了!
事實上我只是一個務實想做出可用軟體服務大眾的廠商而已,跟學術界各單位比拚甚麼世界冠軍的辨識率?不是我的重要目標。但是我必須讓更多人知道我做的研究,讓大家相信Rule based方法真的可以做到跟DL與CNN一樣高的辨識率!也必須取信於人,讓大家相信我不是在網路上胡說八道的網紅,所以我將我的辨識核心做成一個簡單的展示軟體,讓大家自由下載測試:
http://www.ezonesoft.com.tw/EzoneSoft_HWdemo.rar
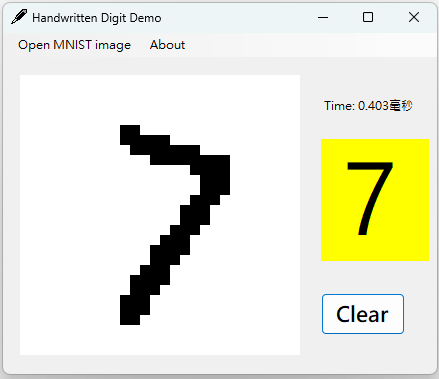
這個軟體的主要介面很簡單,只是一個可以用滑鼠模擬手寫數字做辨識的影像框,為了展示我的辨識速度有多快,寫字的過程中任何一個畫素的影像變化都會做一次辨識!每次辨識用的時間也會即時顯示,大概就是一毫秒上下!所以一邊寫的時候答案就會一直改變了!滑鼠反應也不會因為這些即時運算產生延遲卡頓,非常好玩!
這也算是刻意炫技了!因為我知道所有高辨識率的DL與CNN方法做的辨識模型速度都非常慢!所以MNIST這套他們說機器學習作手寫數字辨識的Hell world已經高掛二十多年,也在二十多年前就已經「有人」辨識率突破99%了!但是市面上始終看不到這些研究成果衍生的商業軟體?就是卡在辨識率雖高,但是計算量太大執行速度太慢,模型也太龐大一般電腦裝不下之故!我想讓大家看到我的Rule based成果和DL與CNN的巨大效能差異!
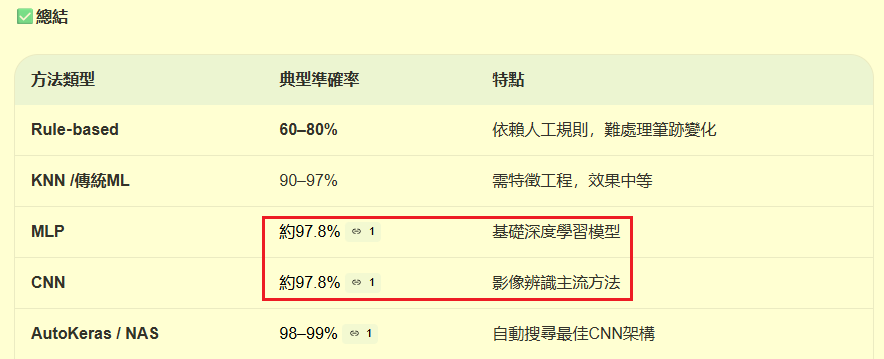
所以我認為我的研究最重要的意義並不是我的辨識率是否擊敗DL與CNN?而是使用Rule based的方法做出的軟體絕對比他們快上幾十甚至幾百倍!如果我可以至少追高到與一般DL與CNN能做到的辨識率差不多,又可以輕易的在一般的電腦上安裝運作,那就是解決了一個卡關已二十多年的影像辨識商業障礙了!
很高興昨天先後收到兩位讀者回應,表示我的努力真的有人看到了!一個是已經在使用我的車牌辨識軟體的某政府單位資訊人員,另一個居然是中央研究院的資訊技術人員?他們都下載了我公開的軟體,至少知道我不是吹牛的詐騙集團!後者比較學術派,問我有沒有相關研究資料?其實就只有我每天寫的部落格文章了!按照發表時間順序整理列表如下:
Rule-based 的手寫數字辨識,兩周就突破九成辨識率了!
我的手寫數字的辨識邏輯小孩都能說清楚的!Google AI有在Follow哦!
Rule based手寫數字辨識之「通則」與「特例」的洽當組合是推高辨識率的關鍵!
Bing AI說Rule based手寫數字辨識已死!我不同意!
這就是一個Overfitting硬抝辨識率的實例,Rule based也可以的!
仔細想想這種Overfitting也不會影響大局的!就做了吧?


限會員,要發表迴響,請先登入


