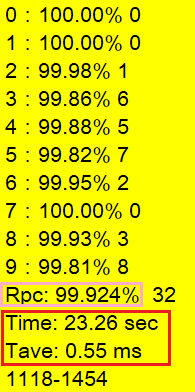
我用我的Rule based研發技術跟MNIST的手寫數字辨識率周旋了幾個月,其實真正的目標只是在證明我可以做到跟ML/DL/CNN一樣好!是否贏過他們?並不重要!Rule based技術20年來完全被ML/DL/CNN打趴,根本的原因就是被認定辨識率遠不如ML/DL/CNN!所以20年來,不論是學界或業界,相關議題都只是談如何使用ML/DL/CNN而已!
但是如果Rule based的辨識率可以做到跟ML/DL/CNN一樣好呢?甚至不必更好!代表的意義就是辨識成本的巨幅下降!我剛剛做了一點計算時間的調整,將磁碟檔案讀寫的時間忽略,就是純粹呈現辨識MNIST案例時的電腦計算時間,如上圖所示:辨識42000個案例的時間僅需23.26秒!一個字平均僅0.55毫秒!
這才是我做這個研究最值得驕傲的數據成績!也是ML/DL/CNN技術始終不願面對的最大問題!我最想爭取的競賽優勝其實不是辨識率,而是這種辨識效能!因為這代表著我的影像辨識產品預期的成本!不論是我的研發成本或是日後客戶使用時的營運成本,都會因為可以使用Rule based技術而大幅下降!
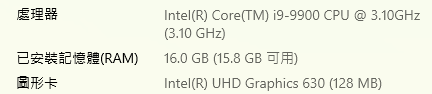
須知我的0.55毫秒的成績是跟GPU等硬體加速設備毫無關係的!我用的電腦就只是如上約七八年前買的一般規格而已!我的辨識程式也完全沒有用CUDA呼叫GPU協助!甚至所有計算都沒用到CPU的多核心平行運算!只是使用CPU之中的單一處理器做計算就這麼快了!

程式執行時使用的電腦資源呢?如上圖所示,CPU僅用6.1%,記憶體只用34.6M,磁碟3M/sec,網路流量當然是0囉!我的程式沒有後門的!所以我日後用此辨識核心製作的辨識產品,完全不會挑電腦!也不必加裝特殊顯卡,即使你到大買場買最便宜的電腦跑起來也毫無窒礙的!同樣的演算法甚至可以遷移到更低階的微電腦(或手機)上都不會跑不動的!
我想如果我的Rule based技術成功推廣之後,硬體商和ML/DL/CNN技術的專家會很不高興!運算量大減之後當然就不需要那麼多算力資源,也就是很多周邊硬體設備,硬體商的商機變少當然不高興!吹捧ML/DL/CNN的專家則是面子掛不住,當然教學與相關工具軟體的商機也大減了!
但是同時間願意考慮改用Rule based開發辨識軟體的廠商會得利!使用者更是最大的受益者!可以買到便宜又快速好用的辨識軟體,還不必加購很多周邊硬體!無形的利潤還有營運時省下的高額電費!省電也代表節能減碳愛地球!我這個海洋博士也算是替我們唯一擁有的地球做出一些貢獻了!

限會員,要發表迴響,請先登入


