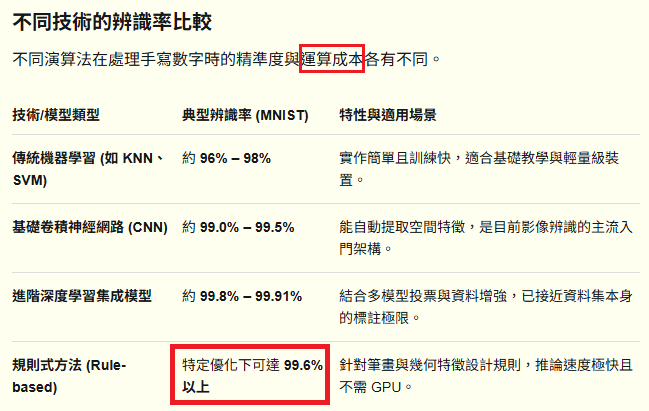
現在每天都會試著問Google AI:「手寫數字辨識率」這個詞!也常撰文評論其中的真實度與合理性,目標就是根據我的實務與實作經驗,盡力戳破也釐清一些ML/DL/CNN刻意避而不談的敏感問題!這好像是在跟Google AI打筆仗?狗吠火車有沒有用呢?似乎是有點用的!譬如我一直強調要注意這些演算法的成本效益,今天看到的報告標題上就有「運算成本」這個字眼了!
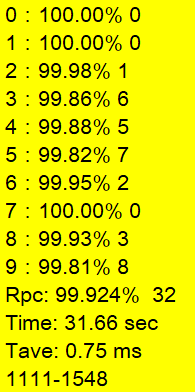
雖然我不想將ML/DL/CNN視為勢不兩立的敵人,但是已經在王位上太久的ML/DL/CNN似乎相當忌憚Rule based方法的復甦?上面提到的Rule based評語首先就刻意迴避了我的Rule based辨識率已突破99.92%的資訊,99.6%這個數字有何特別?在我發表的諸多相關文章中根本沒有特別意義!報告選擇性引用這個數字唯一的目的似乎就是剛好比深度學習項目表列的99.91低一點而已!
即使數字上已經刻意迴避讓Rule based領先了!但Goole AI還要刻意給Rule based加註是在「特定優化下」才能達到此高辨識率?好像在暗示Rule based必須依賴甚麼不正當的處理過程似的?但這個優化是完全子虛烏有的!我就只是按一般程序做灰階二值化處理而已,這部分與ML/DL/CNN的辨識過程是完全一樣的!
所以Google AI刻意保護ML/DL/CNN方法,也刻意貶低Rule based的意圖實在太明顯了!根本是斧鑿斑斑此地無銀三百兩!但我想這是二十年來的趨勢主流,不會覺得太奇怪!只是看得很有趣,也必須刻意點出,讓讀者們注意到這些不合理的地方!一方面替弱勢的自己(Rule based)發聲,一方面也希望適度導正影像辨識過度傾斜到ML/DL/CNN的不合理現象!
我相信事實終究會勝於雄辯!到最後ML/DL/CNN成本太高的問題一定會被高辨識率的Rule based研發成果的出現凸顯放大!我只是提前看到告訴各位讀者而已!希望我的讀者都可以比較聰明的不要誤踩到這個地雷!有需要相關AI產品時能做出聰明合理的選擇!

限會員,要發表迴響,請先登入


