CNN手寫數字辨識的時間要多久?我的Rule based呢?
2026/11/11 03:10
瀏覽76
迴響0
推薦0
引用0
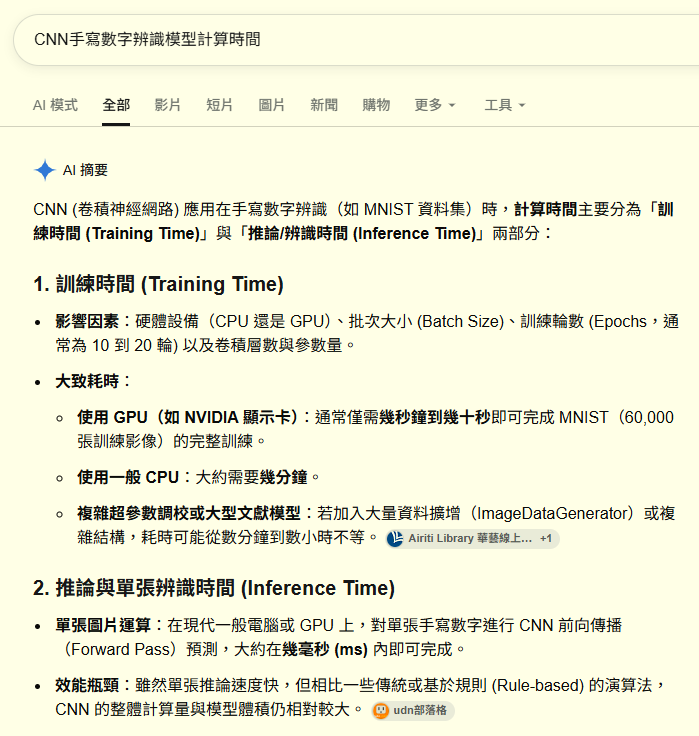
上圖是我查到的CNN手寫數字辨識模型的耗時狀況,下圖是我用Rule based開發的系統耗時,我的Time就相當於他們說的「訓練時間」,我的Tave就相當於他們說的「推論與單張辨識時間」!即使他們使用GPU協助時辨識一張影像也需要數毫秒,我的系統不須GPU也只需要約0.8毫秒!這是多少倍的差距?
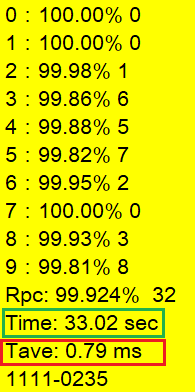
我的42000張的單次訓練時間,不必GPU協助,也只需要33秒!他們如果不用GPU就至少需要數分鐘!這又是多少倍的效率差距呢?很高興我的努力成績Google AI已經注意到了!所以在上面Google AI報告的「效能瓶頸」項目上,算是對我的研究做了一個公允的評論介紹!
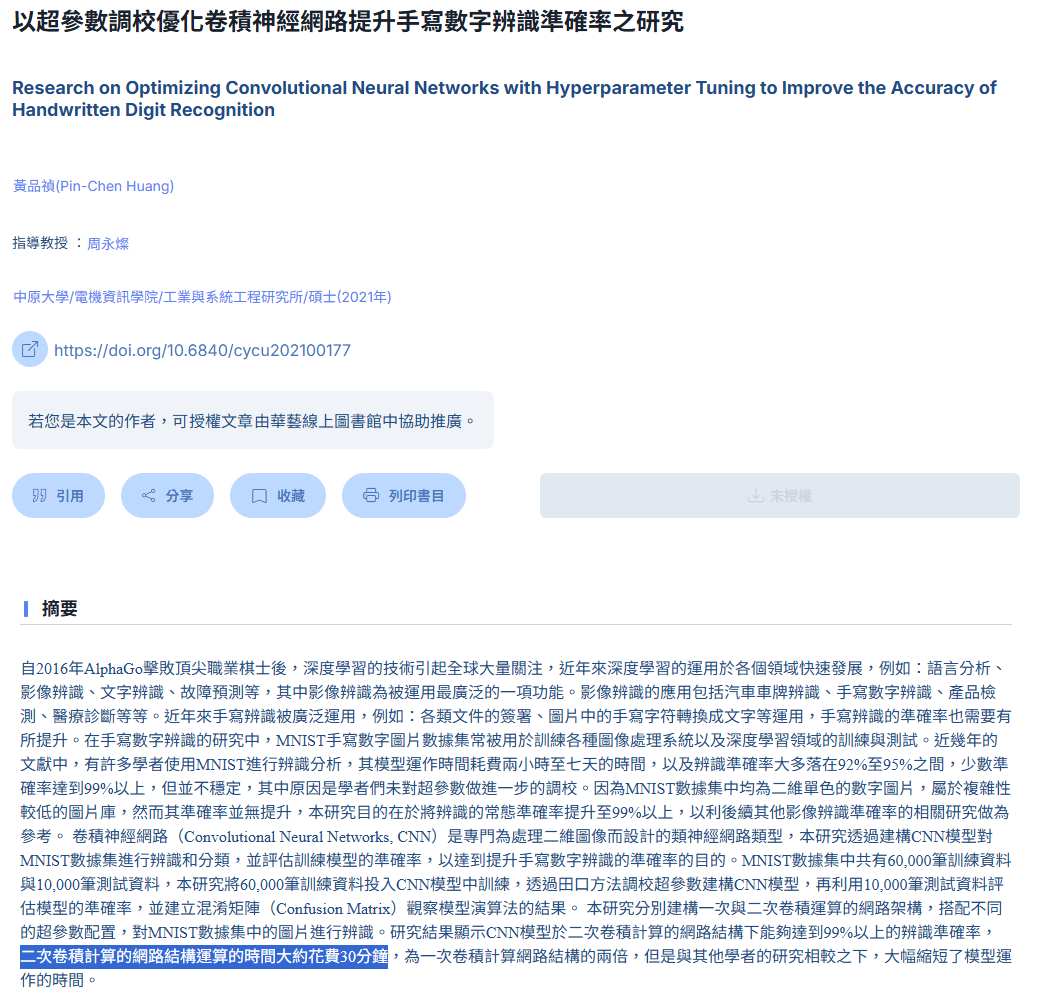
簡單說,CNN與深度學習等模式就是非常耗時低效率的!類似下面的很多研究論文都會提到,實驗室的訓練與真實使用環境的差異還是有落差的,想要更符合真實狀況,模型總是要繼續訓練調整的!如果是我的Rule based系統,所有異常辨識案例為何失敗的原因都是透明可追蹤的!所以只要針對性調整即可。調整後錯誤案例保證可以變成成功,對其他案例的影響也可以準確掌握!
但是CNN與DL就必須拿更多資料重作完整的全程訓練,而且因為是個操作者也無法精準掌握的黑盒子嘛!費事做了更深度的訓練,也不能保證之前失敗的案例訓練之後就一定可以辨識成功的!這就是Rule based與DL/CNN方法上極大的差異!不論是開發訓練或上線執行的效率都是數十,乃至上百倍的差距!如果Rule based的辨識率真的遠不如CNN,那就是不得已必須遷就CNN的低效率!如果Rule based的辨識率事實上已經超車CNN了呢?為何還是不用Rule based系統?

你可能會有興趣的文章:
限會員,要發表迴響,請先登入


