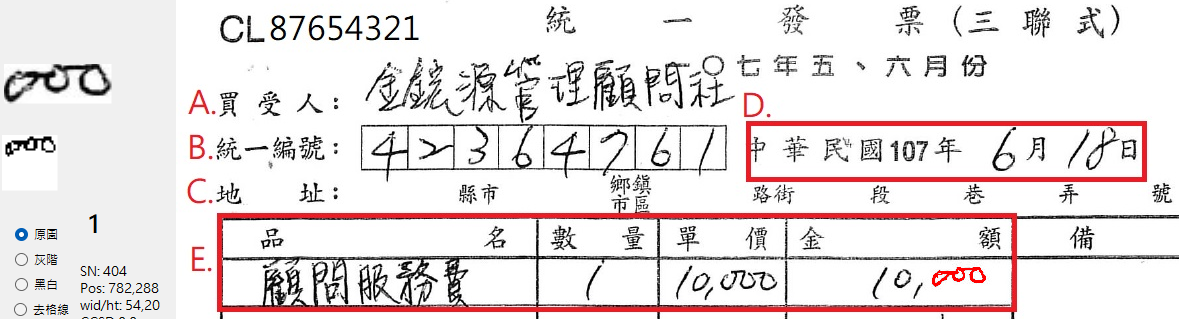
OCR的基本程序是要切割出「獨立」的單一手寫數字,昨天很辛苦的研究出可以將藏在八個方格子裡面的統一編號切割成功了!但那只是一個較簡單的狀況,如上的手寫時就實質沾連的字呢?三個0手寫時就已經是相連的!還通常會比正常的字高度小很多。
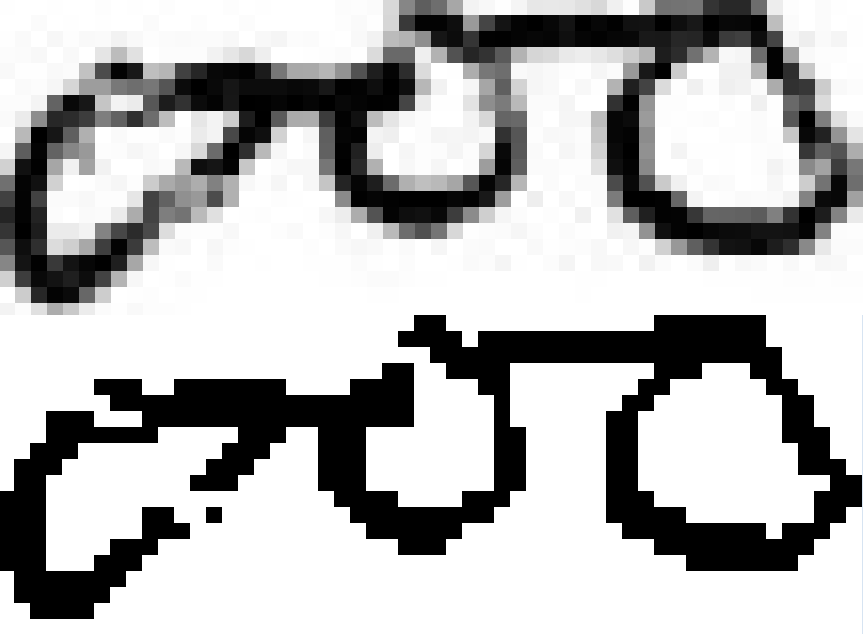
放大來看,二值化之後還不保證三個0都可以自成一個封閉區間!所以寄望用封閉區間來認定單一的0也是不切實際的!大致上我們可以用異常的寬高比,概略判斷它們是相連的數字,但它是兩個0或三個0,甚至四個0呢?也很難判斷的!所以碰到這種狀況我也必須先收集夠多案例才能開始實質研究的!
就是至少需要數十個類似案例,我才能正確的做整體思考,歸納所有變因,設計出可以正確切割它們的一些Rules(組合)!這種辨識預期的複雜度就已經超出傳統的Rule based方法了!所以現階段我只能分析到這裡,讓讀者體會到有這種困難,真要具體解題,就要真的有客戶提供較大量的資料我才能開工的!如果辨識不同的手寫字我都能做到99%了,這類型沾連數字的偵測與切割應該不會更難!
總之就是巧婦難為無米之炊,即使是Rule based方法,碰到不確定性高的問題,也必須有較多資料才能建立出合理有效的Rules來解題的!如果是用機器學習呢?當然就需要更大量的資料!而且也必須有更複雜的標記過程,才能讓模型認知到有這種問題必須處理,這種抽象的問題,其實用ML/DL/CNN等方法,距離解決問題的目標一定會更遙遠的!
也因此,即使你有了99%的單一手寫數字辨識核心,要辨識真實文件中的數字,這類困難還有很多的!所以辨識各類文件才需要高度的客製化嘛!這些客製化的過程大部分就是CNN很難精準掌控的傳統OCR程序!他們會說使用OpenCV的既有函數就能搞定了?但那絕對是胡說八道!沒有對於影像處理的深度理解與底層程式處理能力,根本無法掌握這些複雜問題的!

限會員,要發表迴響,請先登入


