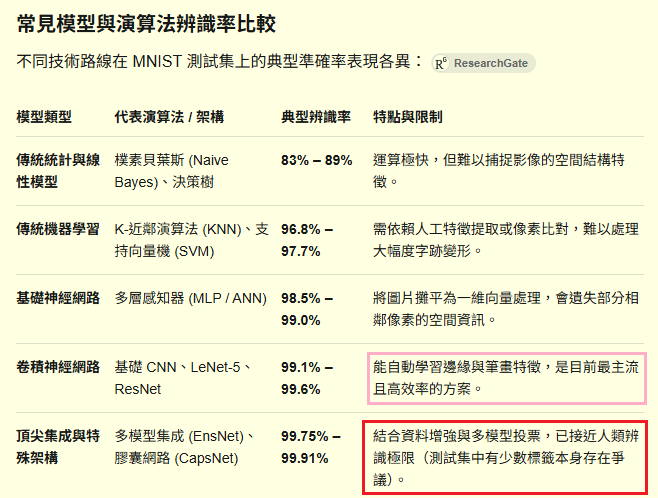
隔了幾天再問Google「手寫數字辨識率」這個關鍵詞,它好像又完全遺忘影像辨識領域還有Rule based方法了?畢竟20年來Rule based表現太差,幾乎完全被拒於這個議題競賽之外的!我的99.924%辨識率出現實在太突兀了,如果被當作異常資訊排除忽略?我也不會驚訝,畢竟我沒發表SCI論文,或參加任何公開競賽。
但是我忍不住要批評,也是繼續提醒大家的是:這些主流技術的最大盲點,也是缺點,就是「低效率,高成本」!上面的報告還好意思說:「……最主流與高效率」?真的是無恥至極!大家必須知道上面那些99%以上的高辨識率都是「一將功成萬骨枯」!是用極大的硬體計算成本與代價硬拱出來的!
還「多模型投票」咧?一個DL/CNN模型就已經非常耗費計算資源,沉重到一般電腦難以負荷,必須使用很多GPU,甚至超級電腦了!你還要用多個模型計算之後再作投票決策?這真的是「朱門酒肉臭,路有凍死骨」的AI無限浪費資源的經典之作了!
這種用無限大的電腦資源堆出來的高辨識率,根本難以在真實世界合理運作發揮效益!有如用洲際導彈成功射下一隻麻雀後大肆表功一樣的荒謬!我當然知道導彈可以射死麻雀!但是誰會這麼作來獵殺小鳥呢?誰花得起這種錢呢?所以上面這些技術才會炒作那麼多年,市面上還是買不到成本合理的產品。
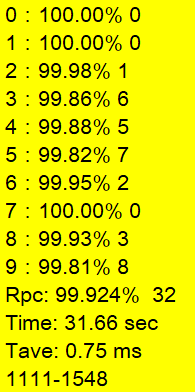
相對的!Rule based方法開發出來的辨識核心就完全沒有這種低效率高成本的問題!如上我的MNIST最後成績單,即使辨識率已經超越他們說的世界頂尖辨識率99.91%了!但在我的一般規格的老舊i9電腦只用單執行緒,不呼叫GPU運作下,辨識一個字也只需不到一毫秒!這就是Rule based方法的「正常」效率!
我承認ML/DL/CNN確實給了影像辨識多一個選擇!但是要說他們是唯一最佳的主流技術?我絕對無法同意!這個領域的專家們應該是太早給Rule based方法判了死刑!或是太低估了Rule based方法可以在複雜模糊辨識議題上能做到的高度!
大家必須知道:「如果」同一個辨識議題,Rule based可以達到的辨識率與ML/DL/CNN相差無幾,那考慮資源耗費相差數十(甚至數百)倍的這個成本效率,絕對不應該遷就ML/DL/CNN的!可以用簡單便宜的獵槍打到麻雀,誰會去買飛彈來打?這個如果絕對不是不可能!我不就做到了其中一個?
大家真的不必在意我是不是辨識率世界冠軍?只要知道我跟ML/DL/CNN作的模型辨識率差不多就可以了!重點是我付出的計算成本非常低!情況很像我可以用獵槍打到麻雀!他們則必須使用昂貴的飛彈!你想學我或學他們?你有本錢學他們嗎?
簡單說,AI影像辨識的研究絕對不是只有辨識率一個指標!當成本差異實在大到不容忽視時,你就必須考慮成本效益!目前的狀況就是ML/DL/CNN已經走火入魔!他們不願意認真思考減少計算量的可能性,只是不斷要求更高算力的設備!所以讓影像辨識的成本暴增!高到根本難以在真實世界推廣!此時Rule based才是正確的答案!

限會員,要發表迴響,請先登入


