如何精準正確的清除格線?是辨識手寫數字的魔王關卡!
2026/11/12 03:15
瀏覽94
迴響0
推薦1
引用0
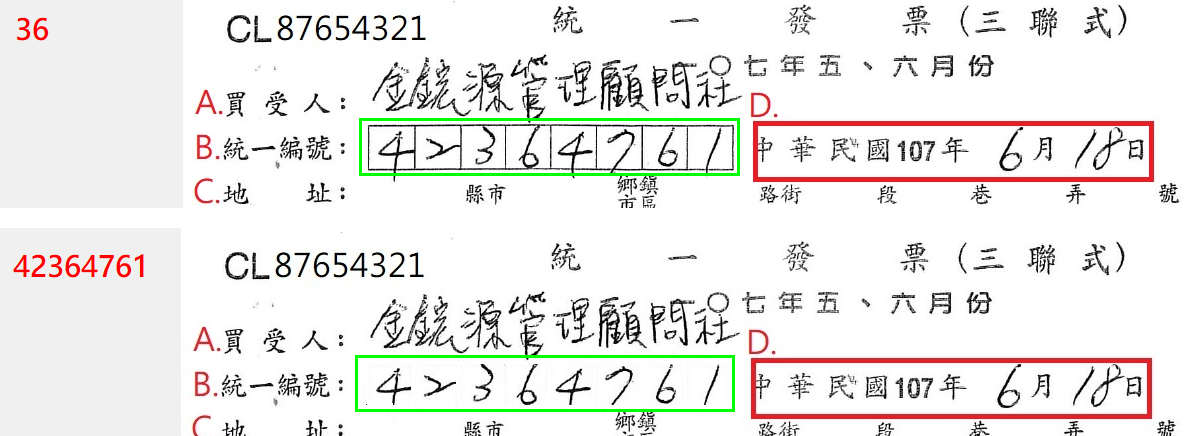
即使花了三個多月大致上克服了「獨立的」手寫數字的辨識問題,但是要進入真實文件上的手寫數字辨識仍有非常多的難關!第一個必須面對的就是表格線的問題了!在各式文件上要求手寫數字的地方一定有一些印刷的標示,引導使用者在那個位置寫字!主要就是類似如上填寫統編的格子了!
如果不理會這些格子,如上圖上直接用綠框定義要求辨識,結果只會出現兩個數字36,為什麼?原因就是大部分的數字都與格線有接觸沾連!如果我作弊,用小畫家的橡皮擦手動擦掉格線呢?結果搭配我的新武器就可以很正確的辨識出完整的統一編號了!
我的大挑戰就是如何不用小畫家的橡皮擦,而是用我寫的程式,來擦掉格線又不會破壞手寫數字的完整性?所以如何正確「辨識」或「認知」出那些格子的準確位置,而且是在如此複雜的背景之中,就是真正的影像辨識技術了!這種事情我當然是會用「Rule based」方法來實現的!要交代機器學會這種事情?還要先收集與標記幾百幾千張資料影像?太難了!比想出格線辨識邏輯更難!
事實上我已經有了初步粗略去格線的程式,有點像是某種CNN?我會在圖中嘗試掃描找到大致水平的長直線,然後清除此線的上下一兩點,譬如下面就是清除格線前後的效果:
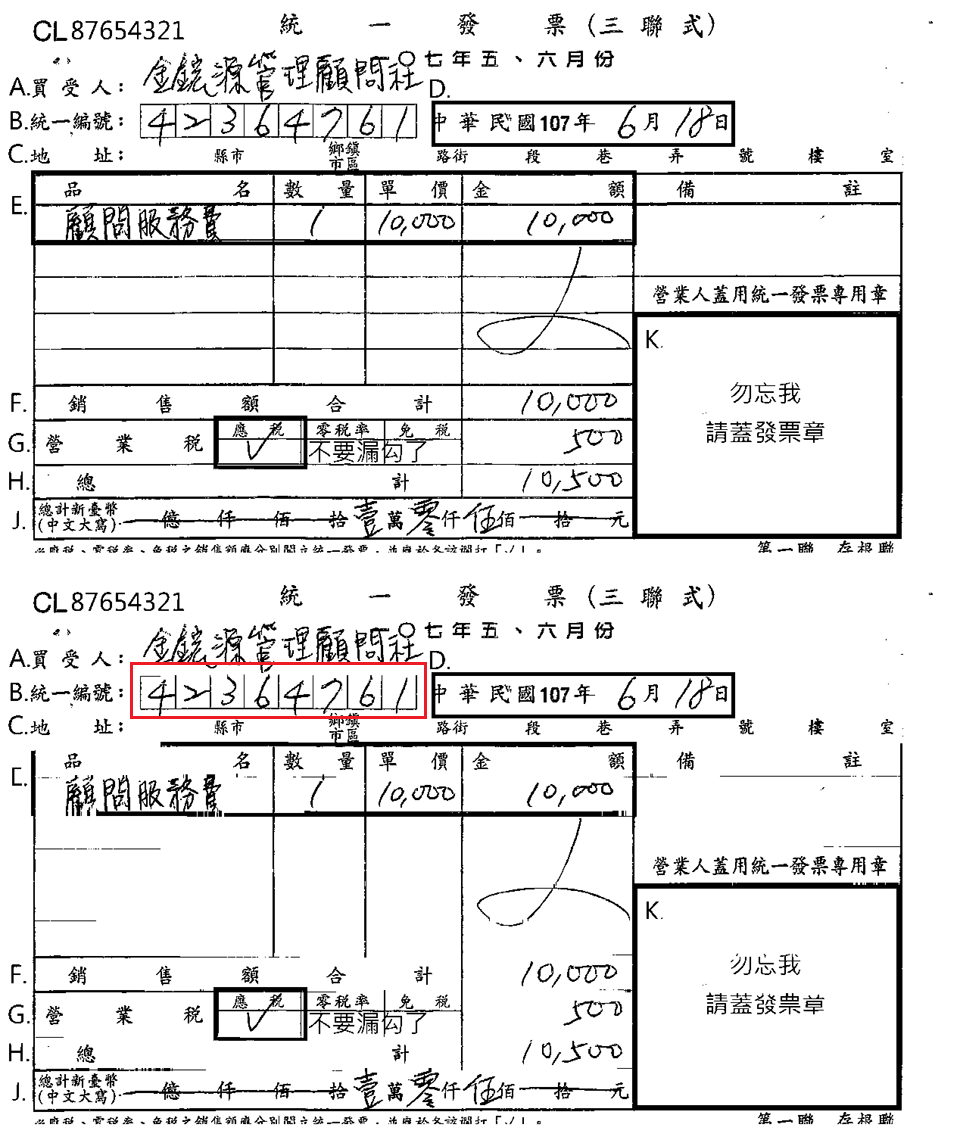
但是顯然還很粗略,清除得並不精準完整,如上統一編號的格子就做得零零落落,上線清了下線卻沒有。該怎麼辦呢?還是要向CNN概念求救了!就要找到較短的水平線,再檢視是不是有等間格的較短垂直線了!這就是傳統的OCR技術較難做到的事情了!OCR必須先將目標切割出來再做後續處理,連成一氣的格子們與數字們當然無法切割!此時就一定需要用CNN的掃描搜尋概念來找目標了!
所以我也不是完全不用CNN的!只要有針對性的需求,任何方法都有存在的價值!我完全沒有偏見的!


你可能會有興趣的文章:
限會員,要發表迴響,請先登入


