


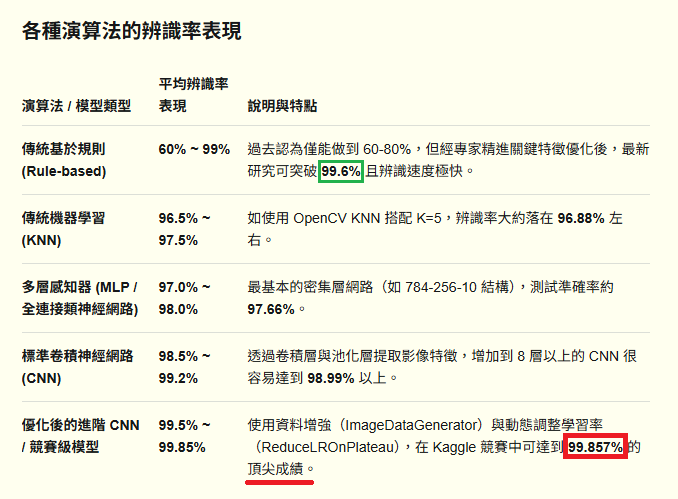
上面是Google AI的最新手寫數字辨識率報告!終於跑出了一個具體的冠軍辨識率99.857%!這馬上就激起了我的鬥志!我昨天的辨識率是99.852%,距離只有一步之遙,哪能不更進一步積極奪冠?於是再打開程式強攻剩餘的數十個昨天尚無法辨識的案例,經過一天半的努力,也真的破解了好多案例!辨識率直接衝上如下圖所示的99.914%!這下可是穩坐世界冠軍的寶座了吧?
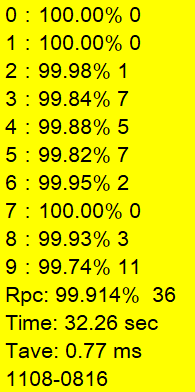
覺得我是夜郎自大太過浮誇嗎?那就下載我的展示軟體自己測試吧!它可以一一匯入MNIST(規格)的灰階圖案例做辨識的!我不會作假,也不屑於作假的!
http://www.ezonesoft.com.tw/EzoneSoft_HWdemo.rar
其實因為我是使用明確的規則(Rules)作辨識的!所以對於極端特殊的案例只要努力思考出夠多的細節資訊加以限制,就可以針對性地將困難案例精準掌握辨識成功!相對的DL與CNN的方法都是隔靴搔癢,要透過非常龐大複雜難以掌握的間接統計方式才能提高辨識率。所以只要我的基礎建設做得夠好了,要在這個牛角尖裡面比拚極端的辨識率,無法精準分析掌握個別案例的DL與CNN其實是一定比不過我的!
當然說實話,這種微小也極端的辨識率差異,對於日後實質應用時的辨識能力差異是微不足道的!只表示我們的程式可以辨識出MNIST字集裡面非常詭異不合理的極端案例,但那些都算是隨機誤差了!真實世界剛好會出現那種怪例的機會微乎其微!所以認真比拚這種極高辨識率,真的就是在鑽牛角尖了!就像考試99分的說自己比98分的更厲害?其實沒有!
那我這麼執著爭取世界冠軍的意義何在?首先就是要破除Rule based方法無法達到高辨識率的錯誤觀念!證明設計良好的Rule based方法,絕對可以挑戰,甚至超越深度學習的表現!一旦Rule based做到了高辨識率,就表示我們可以同時享受到高辨識率與高效率,製作出低成本的AI辨識軟體!那才是AI影像辨識的大躍進!
事實上,如我之前一再強調的,在此手寫數字的辨識議題上,98%以上的辨識率其實就算是Overfitting了!根本沒有必要繼續追高!以深度學習的理論上來說,只要使用更多細節特徵(與組合),讓模型複雜度無限擴大,在有標準答案的集合裡,辨識率當然可以繼續挑戰極限!但是使用極高成本,追求極微小的效能提升有必要嗎?
我刻意搶奪這個議題的世界冠軍,只是要踢館衝擊那些認定DL與CNN就是影像辨識唯一主流的AI迷!那絕對是一個錯誤的迷思!Rule based之前表現不夠好,不是這個概念方法本身有問題,只是大家還不夠努力而已!尤其是機器學習盛行之後,幾乎所有人都放棄努力了?不再繼續研究的技術怎麼會進步?現在Rule based方法真的成了辨識率冠軍,你們該怎麼說?還要繼續堅持DL與CNN最棒嗎?
此研究歷程相關文章羅列如下,一般來說這樣一個全新架構的複雜研究議題,如果我還是學界教授,也申請得到計畫經費,至少可以做上三年!過程中為了繼續爭取「研究績效」當然會寫很多論文,至少七八篇吧?因為又要被評鑑,又想升等,還要爭取計畫嘛!但現在我只是想盡快做出實用軟體的商人,就可以用10倍的速度三個月就達標了!可見在學界當教授做研究真的非常沒效率浪費時間。但很現實的是:如果我還在學界應該已經可以藉此拿到計畫甚至獎勵,現在呢?還完全沒有實質回報,要等有需要的客戶青睞才能回收研發成本與心力了!
Rule-based 的手寫數字辨識,兩周就突破九成辨識率了!
我的手寫數字的辨識邏輯小孩都能說清楚的!Google AI有在Follow哦!
Rule based手寫數字辨識之「通則」與「特例」的洽當組合是推高辨識率的關鍵!
Bing AI說Rule based手寫數字辨識已死!我不同意!
這就是一個Overfitting硬抝辨識率的實例,Rule based也可以的!
仔細想想這種Overfitting也不會影響大局的!就做了吧?
我的Rule based手寫數字辨識率達到99%的里程碑了!
你知道Rule based比機器學習模式的效能好上多少倍嗎?
你知道Rule based辨識速度的差異來自「定量」或「定性」使用各種特徵!
