🔒 「AI輔助文件去識別化系統」上線,歡迎試用並回饋意見
這幾個月到各縣市的社福與心理機構分享時,最常被問到的幾乎都是:「把個案資料交給 AI,真的安全嗎?」這個問題背後,是第一線工作者很實際的處境:社工訪視回來的逐字稿、心理師晤談後的個案紀錄,本來就是一天裡最耗時的工作之一,AI 明明能幫上忙,卻又擔心一不小心,個案的名字、電話與住址就跟著送了出去。於是不少人只能二選一:不用 AI,繼續熬夜整理紀錄;或是自己一個字一個字地刪掉名字,刪完仍不放心。
颱風假的週末,我為了完成〈擔心 AI 洩漏個案隱私,該怎麼辦?〉這篇長文,順便查了一些資料,才發現公開的資源裡,能處理繁體中文的類似工具似乎很少,有的也不太適合逐字稿這種口語、帶著錯字的文字。既然如此,我就順手用 Claude Code,把原本用在「AI社工紀錄輔助系統」裡的遮蔽技術搭成一個獨立的網頁,也做了些測試,發現效果還不錯,召回率超過97%以上。所以現在把它公開,開放給所有助人工作者試用,也想聽聽大家實際用起來的感受或需要改善的地方。
🔗 系統網址:https://hssai-privacymask.phys.nthu.edu.tw/(導覽列有「使用說明」與「技術說明」)
📖 相關長文:〈擔心 AI 洩漏個案隱私,該怎麼辦?〉https://blog.udn.com/dawweiwang/192663455
💬 意見回饋:下載結果後有選填問卷,也歡迎來信 aifr.general@gmail.com
⚙️ AI可以怎麼幫上忙
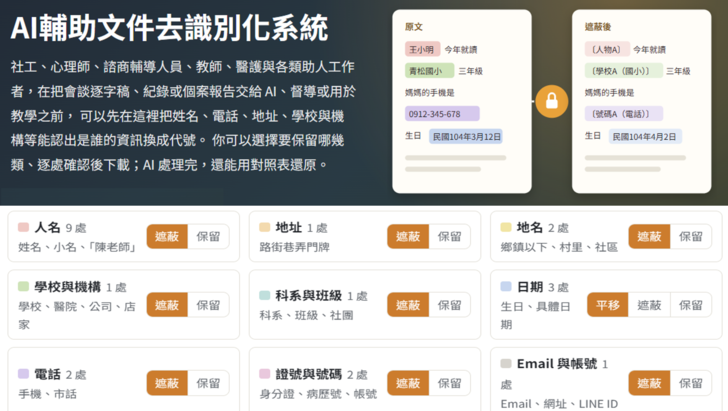
例如剛做完家訪、手上有一份逐字稿的社工,想請 AI 協助整理成訪視紀錄,卻不想讓個案的真實姓名與住址離開自己的手。只要把文字貼進來(或上傳 .txt、Word、PDF、Excel 檔),系統會找出姓名、小名、地址、學校與機構、電話、證號、日期等可識別資訊,換成代號後再下載;等 AI 寫好了,還可以用對照表把代號換回原本的內容,不必一個個手動改回來。心理師的情形也類似:晤談後的個案紀錄,或想和 AI 討論的個案敘事,同樣含有當事人的姓名、學校、家人與住處。只處理繁體中文,每次最多 3 萬字(約一小時的會談逐字稿)。同一套技術也已用在「AI社工紀錄輔助系統」:社工產生訪視紀錄、處遇計畫與家系圖時,系統會在送出前自動遮蔽、產生後再還原,操作流程不變;「校園輔導/諮商AI增能平台」裡的「個案分析輔助系統」也已加上這項功能,心理師輸入個案敘事時,系統會在送出前自動遮蔽、回覆後再還原。
用起來分四步:
1. 加入資料:貼上文字或選擇檔案,按「開始偵測個資」。
2. 決定要保留什麼:九個類別預設全部遮蔽;例如教學用途想保留日期,可以單獨改為保留。
3. 親自看過一遍:全文以顏色標出系統偵測到的每一處,點一下就能在遮蔽與保留之間切換,漏掉的地方可以反白補上。畢竟最後把關的,還是使用者自己。
4. 下載:結果存成 .txt 或 Word;之後若要還原,另設密碼下載加密的對照表。
🧩 設計時想到的幾件事
助人工作者要的,不只是把名字蓋掉。逐字稿和新聞、公文不同,充滿「阿明他媽」「林阿嬤」這類稱謂、念出來的電話號碼,還有語音辨識的錯字;遮蔽之後,AI 還得讀得懂,寫出來的紀錄也要能用。因此本系統先以固定規則找出格式固定的號碼與日期,再請開源模型 Gemma 4 31B 判斷人名、小名、地名與機構,兩者的結果合併;設計上偏向多標,漏標比誤標更需避免。換成代號時,特別顧及兩件事:
1. 讓 AI 仍讀得懂:「王小明」換成〔人物A〕,「青松國小」換成〔學校A(國小)〕,同一個人全文用同一個代號,AI 知道誰是誰、那是一所國小。
2. 讓時間關係不亂:有「日」的日期不換成代號,而是整份文件一起挪動 2 至 6 週(7 的倍數,星期幾不變),AI 仍能推算年齡、年級與事件先後;只有年份或年月的不動。下載結果裡的日期不是真實日期,用對照表還原才會移回。
還原同樣在瀏覽器裡完成,AI 改寫過的文字也能還原。對照表以使用者自訂的密碼加密,內含原本的個資,請與遮蔽後的結果分開保存;密碼無法找回。
🗺️ 資料會到哪裡
本系統不是完全在使用者電腦內運作的工具,偵測所需的文字會離開使用者的電腦。
・ 讀檔、換代號、日期平移、對照表與還原,都在使用者的瀏覽器內完成,對照表從不經過伺服器。
・ 文字會先送到本站伺服器(國立清華大學),其中人名、地名等的判斷主要交給國網中心的 AI 平台;該平台無法使用時,改由清華大學校內伺服器上的同一個模型處理。兩處都在台灣境內;國網中心平台自身的資料處理方式,我們不代為說明,請以該平台的公開規範為準。
・ 本站處理完立即丟棄,不存檔、不記錄內容;系統紀錄只有字數、各類個數與處理時間等統計,不含內容。
📊 先用虛構資料試試看
我們先做了初步測試,資料是虛構、由我們自行設計的,結果僅供參考。測試用了 70 份虛構的社工訪視逐字稿與心理師紀錄(約 28 萬字),刻意放入口語念出的電話、小名、錯字等真實逐字稿常見的寫法,其中 30 份在調整規則時刻意不看。以每個個資片段計算,找出的比例約 97% 至 99.7%,被誤標的一般詞約 0.1% 至 1.7%。作為對照,中研院 CKIP 這類以新聞等正式文字訓練的實體辨識工具,在同一批資料上找出人名、地名與機構的比例約 32% 至 66%,原因見技術說明頁。比例數字看不出的是:一份逐字稿有數十處個資,只要漏掉一處,整份就不算乾淨,這也是下載前仍須自己檢查的原因。
⚠️ 還有幾件事請留意
・ 無法保證完全沒有遺漏。本系統的定位是協助降低風險,不是完全去識別化,下載前請自己讀過一次。
・ 情境描述無法靠遮蔽處理。家庭結構、特殊身分或事件合在一起,仍可能讓熟悉的人認出是誰。
・ 遮蔽不取代機構規範。個案資料能否交給 AI,仍須依所屬機構的規定與當事人同意辦理。
・ 只處理繁體中文;掃描檔與圖片目前不支援。
・ 為維持服務穩定,每次最多 3 萬字,每個網路位址每小時最多使用 10 次。
🤝 期待與規劃
我們希望,助人工作者不必在「用 AI 節省時間」與「守住個案隱私」之間二選一,省下來的時間,也能還給自己與生活。本系統目前免費提供各界使用,期待也樂見更多助人專用的 AI 工具出現。使用後的任何感受與建議,都歡迎直接告訴我們。未來如果能達到效果且仍有需要,也不排除透過外接API或開源的模式來推廣。


