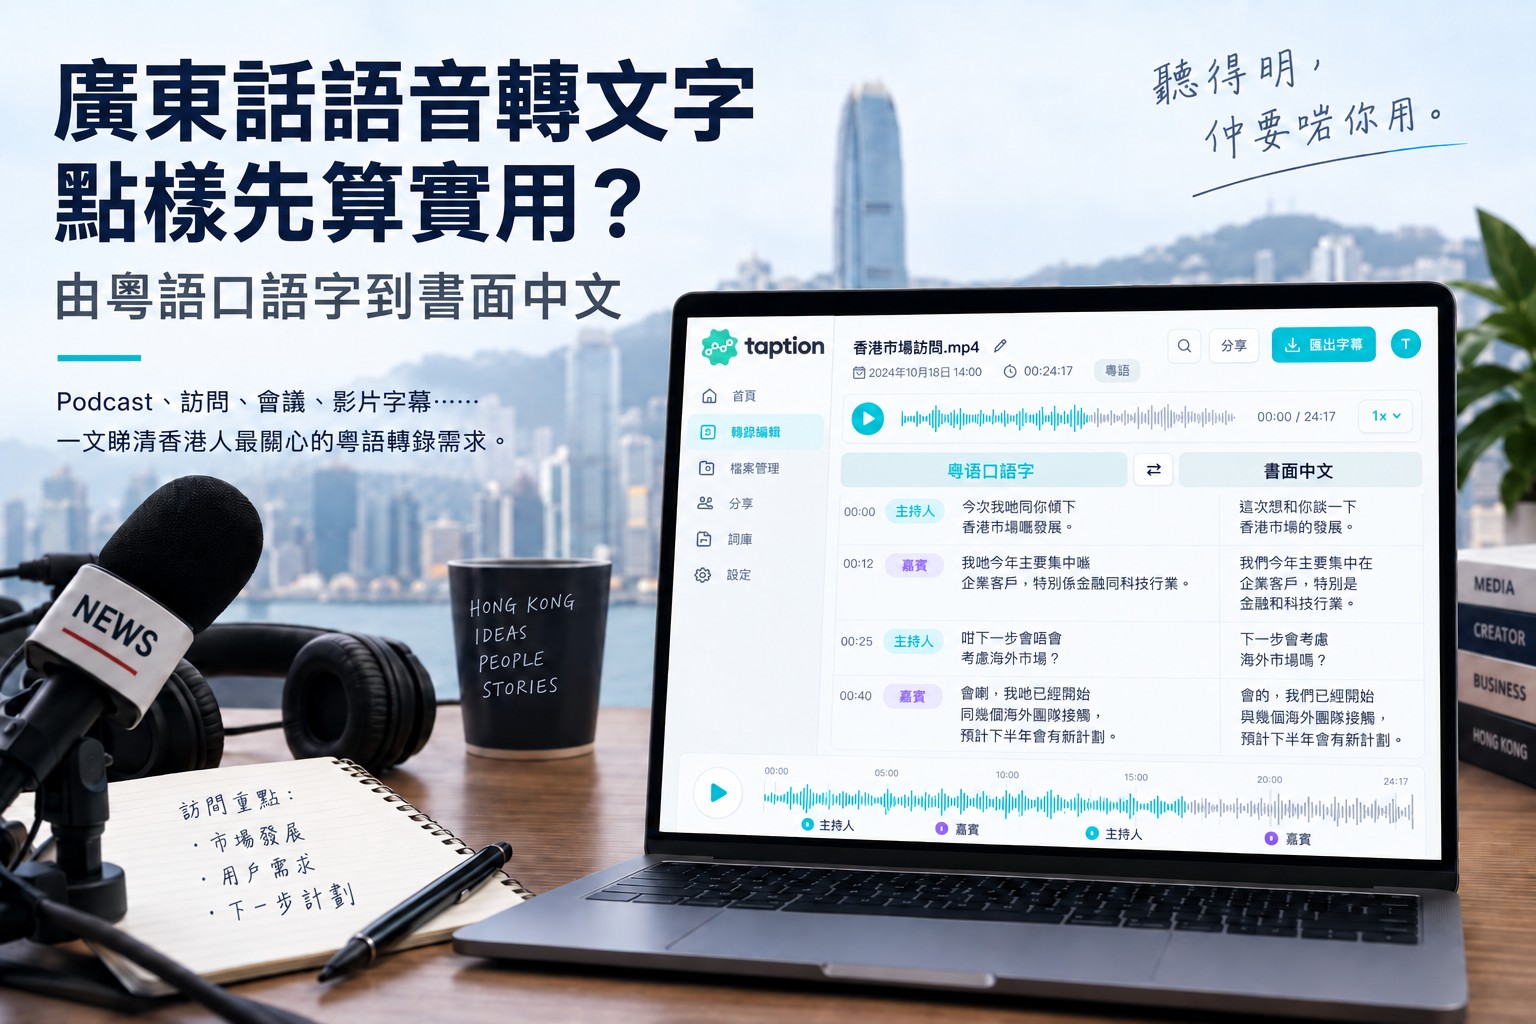
香港人每日都講廣東話,但當一段廣東話錄音真正要變成文字時,問題往往比想像中複雜。
同一句:
佢哋今日唔會嚟,我哋聽日再傾啦。
如果是 Podcast、街訪或 YouTube 字幕,保留「佢哋、唔、嚟、我哋、傾」等粵語口語字,會更貼近講者本身的語氣。
但如果是公司會議紀錄、研究報告或培訓文件,很多人反而會希望看到:
他們今天不會來,我們明天再討論。
兩個版本意思相同,使用情境卻完全不同。
這也是近年廣東話 AI 語音轉文字工具真正要解決的問題:不只是把聲音辨識出來,而是輸出一份「適合用途」的文字。
香港廣東話最大的難題,不只是辨識準確度
粵語和書面中文之間,本來就存在一定距離。
香港日常對話很自然會出現:
● 佢
● 我哋
● 喺
● 唔
● 冇
● 嘅
● 呢個
● 咁樣
● 搞掂
● 返工
這些字並不是錯字,而是香港人每天都在使用的粵語書寫方式。
因此,如果一個系統把所有廣東話內容一律改成正式書面中文,對 Podcast、娛樂內容或訪問逐字稿而言,反而可能失去原來的語氣。
相反,一份需要提交給公司、學校或研究團隊的文件,如果全部保留口語字,又未必是最方便閱讀的形式。
所以,真正實用的粵語轉錄功能,應該先回答一個問題:
這份逐字稿最後是用來「保留原本說話方式」,還是用來「閱讀和整理資訊」?
兩種常見輸出:粵語口語字與書面中文
保留粵語口語字
如果目的是忠實記錄講者原本說法,可以保留香港常見用字。
例如:
|
原本廣東話 |
粵語文字 |
|
keoi5 dei6 gam1 jat6 m4 lai4 |
佢哋今日唔嚟 |
|
ngo5 hai2 zung1 waan4 faan1 gung1 |
我喺中環返工 |
|
ni1 go3 gung1 nang4 gei2 hou2 jung6 |
呢個功能幾好用 |
|
ngo5 dei6 ting1 jat6 zoi3 king1 |
我哋聽日再傾 |
這種形式比較適合:
● Podcast
● YouTube 字幕
● 新聞訪問
● 街訪
● 電影或節目字幕
● 社交媒體短片
● 語言研究
● 需要保留講者語氣的逐字稿
尤其面向香港本地觀眾時,粵語字往往比正式書面語更自然。
整理成書面中文
另一類需求,是把講者意思整理成較正式的中文。
例如:
|
粵語內容 |
書面中文 |
|
佢哋今日唔嚟 |
他們今天不來 |
|
我喺中環返工 |
我在中環上班 |
|
呢個功能幾好用 |
這個功能很好用 |
|
我哋聽日再傾 |
我們明天再討論 |
這並不是單純把「佢」換成「他」、「唔」換成「不」。
一句自然的廣東話要變成流暢書面中文,通常還需要理解整句語意,再重新組織表達。
這類形式比較適合:
● 公司會議紀錄
● 訪問報告
● 教育內容
● 企業培訓
● 研究報告
● 內部知識庫
● 需要搜尋和整理的逐字稿
香港人講嘢,仲有一個特色:中英夾雜
對香港語音辨識來說,中英混用亦是一個很實際的問題。
例如公司會議可能會說:
我哋今個 quarter 嘅 KPI 要再睇下 conversion rate。
科技或金融訪問又可能出現:
API、SaaS、FinTech、CRM、AI model、workflow
如果 AI 每次都把品牌名稱、英文縮寫或產品名稱辨識錯誤,後續校對時間仍然很長。
因此,除了語音辨識本身,個人辭典、專有名詞管理和批次取代亦變得重要。
例如香港團隊可能經常需要固定保留:
● MPF
● FinTech
● SaaS
● CRM
● KPI
● 公司英文名稱
● 產品名稱
● 客戶品牌
這種「長期詞彙一致性」,對日常實際使用往往比一次性的準確率數字更有價值。
多人訪問:轉文字之外,還要知道「邊個講緊嘢」
Podcast、新聞訪問、會議、焦點小組通常有不止一位講者。
如果系統只是把所有內容變成同一段文字,使用者仍然要重新播放錄音,逐句判斷是誰在說話。
現時部分 AI 轉錄平台已經加入說話者辨識(Speaker Identification / Diarization),先把不同聲音分開,再讓使用者重新命名講者。
例如:
主持人
今次產品推出之後,香港市場反應點樣?
產品經理
暫時反應幾好,我哋收到最多嘅查詢都係企業客戶。
主持人
咁下一步會唔會考慮海外市場?
對 Podcast、媒體訪問、市場研究或會議整理來說,這種結構化逐字稿通常比一大段純文字實用得多。
如果最後是影片字幕,就不只是「轉完文字」
逐字稿和字幕其實是兩回事。
一份可以直接發布的字幕,還需要處理:
● 字幕分段
● 時間碼
● 每句長度
● 顯示時間
● 專有名詞
● 說話者
● 文字校正
● SRT / VTT 等格式
因此,對 YouTube、社交影片或影視內容來說,一個比較完整的流程會是:
廣東話影片/錄音
↓
AI 語音轉文字
↓
選擇粵語口語字或書面中文
↓
校正專有名詞及說話者
↓
調整字幕時間軸與分段
↓
匯出 SRT、VTT 或逐字稿
這也解釋了為甚麼「語音轉文字」和「AI 字幕平台」其實不是完全相同的產品類型。
香港市場開始出現更貼近本地語言習慣的工具
近年部分 AI 影音工具開始針對亞洲語言及本地工作流程作更細緻的處理。
例如 Taption 在廣東話轉錄上,就提供兩種不同方向:使用者可以保留香港常見的粵語口語字,亦可以視用途將廣東話整理成書面中文。
平台同時結合時間軸逐字稿、說話者辨識、個人辭典及字幕編輯,因此比較適合需要由「錄音」一路處理到「可發布字幕或文件」的工作流程。
如果內容中有大量固定英文品牌或專業術語,也可以透過 語音轉文字與辭典功能 進一步校正。
而對 Podcast、訪問或多人會議,說話者辨識 則可以先把不同講者分開,減少後續人工整理。
哪一種廣東話文字形式最適合?
可以簡單從內容用途判斷:
|
使用情境 |
較適合的文字形式 |
|
Podcast |
粵語口語字 |
|
YouTube 香港觀眾 |
粵語口語字 |
|
新聞街訪 |
粵語口語字 |
|
電影/節目字幕 |
視製作需求 |
|
公司會議紀錄 |
書面中文 |
|
企業培訓 |
書面中文 |
|
研究訪談原始資料 |
粵語口語字 |
|
研究報告 |
書面中文 |
|
知識庫 |
書面中文 |
|
社交媒體短片 |
粵語口語字 |
重點不是哪一種「比較正確」,而是哪一種更適合最終讀者。
企業使用 AI 轉錄,資料安全亦開始受重視
如果處理的是 Podcast 或公開影片,資料敏感度可能不高;但企業會議、客戶訪談、內部培訓及研究內容,就可能涉及非公開資訊。
企業在評估 AI 轉錄平台時,除了語言能力,也會開始關注:
● 資料如何保存
● 誰可以存取
● 權限管理
● 資料保留機制
● 風險管理
● 企業資安及合規要求
以 Taption 為例,目前亦正推進 SOC 2 Type II examination readiness 及 HIPAA readiness,加強企業級資料保護與安全治理。
需要留意的是,這代表相關安全及合規工作仍在推進,並不等同已完成 SOC 2 Type II examination,亦不代表取得官方「HIPAA 認證」。
常見問題
廣東話語音轉文字可以保留「佢、唔、喺、嘅」嗎?
可以。部分支援香港粵語的工具可以保留廣東話口語字,較適合 Podcast、訪問、影片字幕及需要保留原本說話方式的內容。
廣東話可以直接整理成書面中文嗎?
可以。若內容主要用於會議紀錄、報告、教材或企業文件,可以將口語廣東話整理成較正式的書面中文。
粵語口語字和書面中文邊個比較好?
沒有絕對答案。
如果重視語氣和本地感,粵語口語字通常較合適;如果重視閱讀、搜尋及整理,書面中文通常較方便。
多人廣東話錄音可以自動分辨講者嗎?
部分 AI 轉錄平台支援說話者辨識,可以先把不同聲音分開,再為講者加入名稱。
廣東話字幕可以輸出 SRT 嗎?
可以。使用具備字幕編輯功能的平台,可在完成校對及時間軸調整後匯出 SRT、VTT 等常見字幕格式。
AI 聽得明廣東話,只是第一步
過去大家評估語音轉文字工具,最常問的是:
「廣東話準唔準?」
但對真正每日處理香港影音內容的人來說,更實際的問題其實是:
轉出來的文字,是否符合最後用途?
Podcast 可能要保留「佢、我哋、唔、喺」的香港語感;公司會議則可能需要一份正式、容易搜尋的書面中文。
再加上中英夾雜、專有名詞、多人講者、時間軸及字幕格式,這些才是香港廣東話語音轉文字真正落地時會遇到的問題。
對使用者而言,與其只看工具標示「支援粵語」,不如直接拿一段真正的香港訪問、會議或 Podcast 測試,看看最終輸出的文字,是否真的符合自己的工作方式。


限會員,要發表迴響,請先登入


