


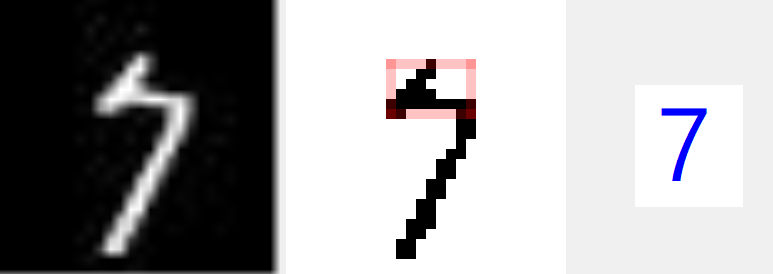
手寫辨識是沒有標準答案的,所以應該是甚麼字?就是要根據很多細微特徵的存在與否?以及同時出現的特徵之間的權重與優先次序來判斷了!如上的案例有趣的是雖然看起來就是一個7字,沒有人會誤認為其他字的!但是如果根據我建立的特徵組合,它也是具有5(甚至3或9)字的彎曲特徵的!
所以我的程式之前會說它是一個5與7的兩難抉擇!我要如何判定是5或7呢?定性的特徵無法決定時就要看該特徵的定量指標了!其實我的幕後專家評審還是一般人的常識與直覺!一般人會說那根主軸直線那麼長!應該就是7了!5不會寫得那麼長的!所以我只要定義何謂「那麼長」的門檻值,判定那根直線長度超過門檻時就可以結案說是7了!
這些邏輯就是CNN與深度學習派的人不想去面對,或是認定根本無法由人的推理手動設計的部分!但是任何方式的辨識其實都一定要產生辨識邏輯與準則!既然不想使用人腦設計,就要讓電腦根據大數據來妥協統計了!但是這樣統計出來的邏輯就會變成一個連訓練模型的人都不能理解掌握的黑盒子了!
其實還有一個更大的無形問題!就是電腦以嘗試錯誤的方式「訓練」出來的模型是只看結果的!所以過程絕對不可能像專家有意識的精準設計那麼有效率,裡面一定充滿了非常多誤打誤撞甚至無效的冗餘運算!就像很多風俗習慣迷信陋規存在人類社會數百年,但是因為沒有人能確實掌握它們的緣起與影響力,就只能因循苟且繼續遵循下去!誰都不敢亂動怕天下大亂嘛!
結果呢?就是一個原本可以針對特定目的設計的精緻小機器,一經過AI的訓練洗禮就變成一個笨拙龐大吃電如喝水一般的怪物了!這就是我認為影像辨識真的不能過度依賴CNN與DL等AI技術的原因!我也持續用我的研發成果證明影像辨識並不是非用這些技術不可的!即使是手寫辨識我都可以做到商用等級辨識率的!
事實是CNN與DL在影像辨識領域的價值只是拉低了進入領域的技術門檻!絕對不是真的可以更精準或快速有效的作出辨識產品!技術門檻是拉低了,但是研發成本的門檻卻變得太高了!更糟的是龐大的模型一旦真的被廣泛使用,無形的耗電成本會讓人十分憂心!最重要的是:這不是無法避免的!任何影像辨識都是可以採用Rule based概念研發設計的!使用CNN與DL絕對不是必要之惡!
