


我看到的大部分非機器學習的傳統辨識論文中,辨識手寫字的思考方向都是簡化(細線化)筆畫為較簡單的線段,然後建立這些線段的位置、長短與指向的資訊!線段們都搞定了,就可以進一步建立這些線段之間的關係特徵,譬如是否交叉,相對位置的高低左右等等。這些數學技巧我在我的博士論文研發時就很熟悉了!
我的RD徒弟讀碩士班時也讀過一些相關的論文,所以她一開始當然也會這麼思考來建立她的辨識邏輯基礎,但是我們平行開發第一周之後她就對我的進度瞠目結舌望塵莫及了!她那些簡化筆畫為線段的程式都還剛剛開始,我的特徵辨識需要建立的程式都已經完成,還開始做整體辨識率的實驗了!重點就是我的創新與創意思維了!因為我用了更簡單更直覺不需要太多數學技巧的方式!
我一直相信人的腦袋不是數位化的!也就是我們的腦袋作影像辨識時考慮的定性特徵會遠多於定量特徵!上面說的很多論文中傳統的作法其實是偏向先做很多量化的分析處理之後才開始考慮定性的判斷過程!我覺得人腦不會那麼喜歡做精密計算的!所以沒有幾個人能像計算機一樣那麼會心算嘛!我們的直覺中包含的數學一定比較簡單!
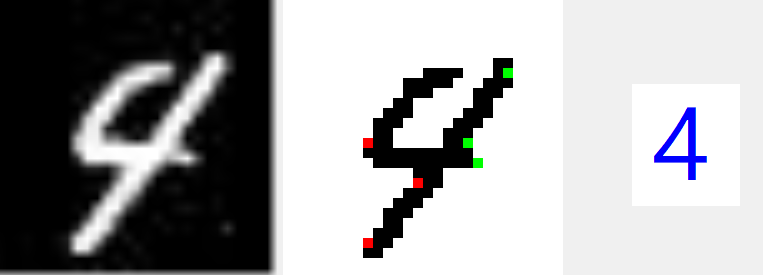
所以我想到不必去費事計算線段筆畫,直接看字形的凹凸點位置就是一個很好的參考特徵了!譬如先看字形的左邊緣的變化,就可以找到如上圖的三個紅點,兩個凸一個凹,右邊一樣可以找到二凸一凹的三個轉折綠點!要計算出這幾個轉折點比嘗試把筆畫變成線段簡單太多了!而且手寫字的筆畫線段常常是彎曲的,硬要Fit成一個線段時很麻煩還誤差很大!所以我省下太多麻煩事,一下子就超車讓我的RD看不到我的車尾燈了!
我現在的程式辨識一個28X28的手寫數字影像約兩個毫秒,如果是用上述的傳統方式呢?應該至少多出數十倍的時間!如果你笨到使用CNN與DL呢?應該是百倍以上的時間!也代表計算量驚人!很難做成可以在一般電腦安裝使用的軟體!我的目標當然不是做出只有雲端超級電腦才能跑的辨識軟體!我的演算法絕對可以做出非常輕量級任何電腦都能安裝的辨識軟體!
事實上,僅僅用這些字形的上下左右凹凸位置與相關性,就已經可以輕易達到九成辨識率了!當然我還會建立出更多的進階特徵,所以目前期望值至少可以突破MNIST字集的95%以上辨識率!由此可以看出演算法的創新程度與創意對於成果的效能影響有多大!在我的這個基礎上,先天就是節能省碳幾十倍的!
簡單說,我就是存心來鬧的!希望用小學生程度的數學能力解開大人們都頭痛的難題!
